Forschungsbericht · 04 · Datenstand 8. November 2026
Bericht 04 · Buchstart und KI-Zitation
Verändert das Erscheinen von »Das vierte Feld« das Zitationsverhalten von KI-Antwortmaschinen?
Zusammenfassung
Dieser Bericht prüft die vorregistrierte Hypothese, dass die Handelsverfügbarkeit des ersten Bandes am 8. Oktober 2026 die Zitation des Autors durch KI-Antwortmaschinen mit Websuche verändert, im Direkt-Kanal früher als im Empfehlungs-Kanal. Primär ausgewertet werden OpenAI mit Websuche und Gemini mit Google-Websuche an den Ankertagen des Drei-Tage-Rasters; die Grundlinie reicht vom 8. September bis 7. Oktober, das Wirkungsfenster vom 8. Oktober bis 7. November 2026.
In der Grundlinie lag die Kopfzahl im Mittel beider Anbieter bei 22,45 Prozent (OpenAI 23,96 an 6 Ankertagen, Gemini 20,94 an 10 Ankertagen) und im Wirkungsfenster, ebenfalls als Mittel der beiden Anbietermittel, bei 25,83 Prozent (OpenAI 25,62 an 10 Ankertagen, Gemini 26,04 an 5 Ankertagen). Ab dem 24. Oktober fehlt Gemini wegen aufgebrauchten Guthabens. Ohne Driftabzug beträgt die Differenz damit +3,38 Prozentpunkte; driftbereinigt, wie vorregistriert, beträgt sie +1,38 Prozentpunkte (95-%-Intervall −3,59 bis 6,68). Das Intervall enthält die Null; die Nullhypothese wird nicht verworfen.
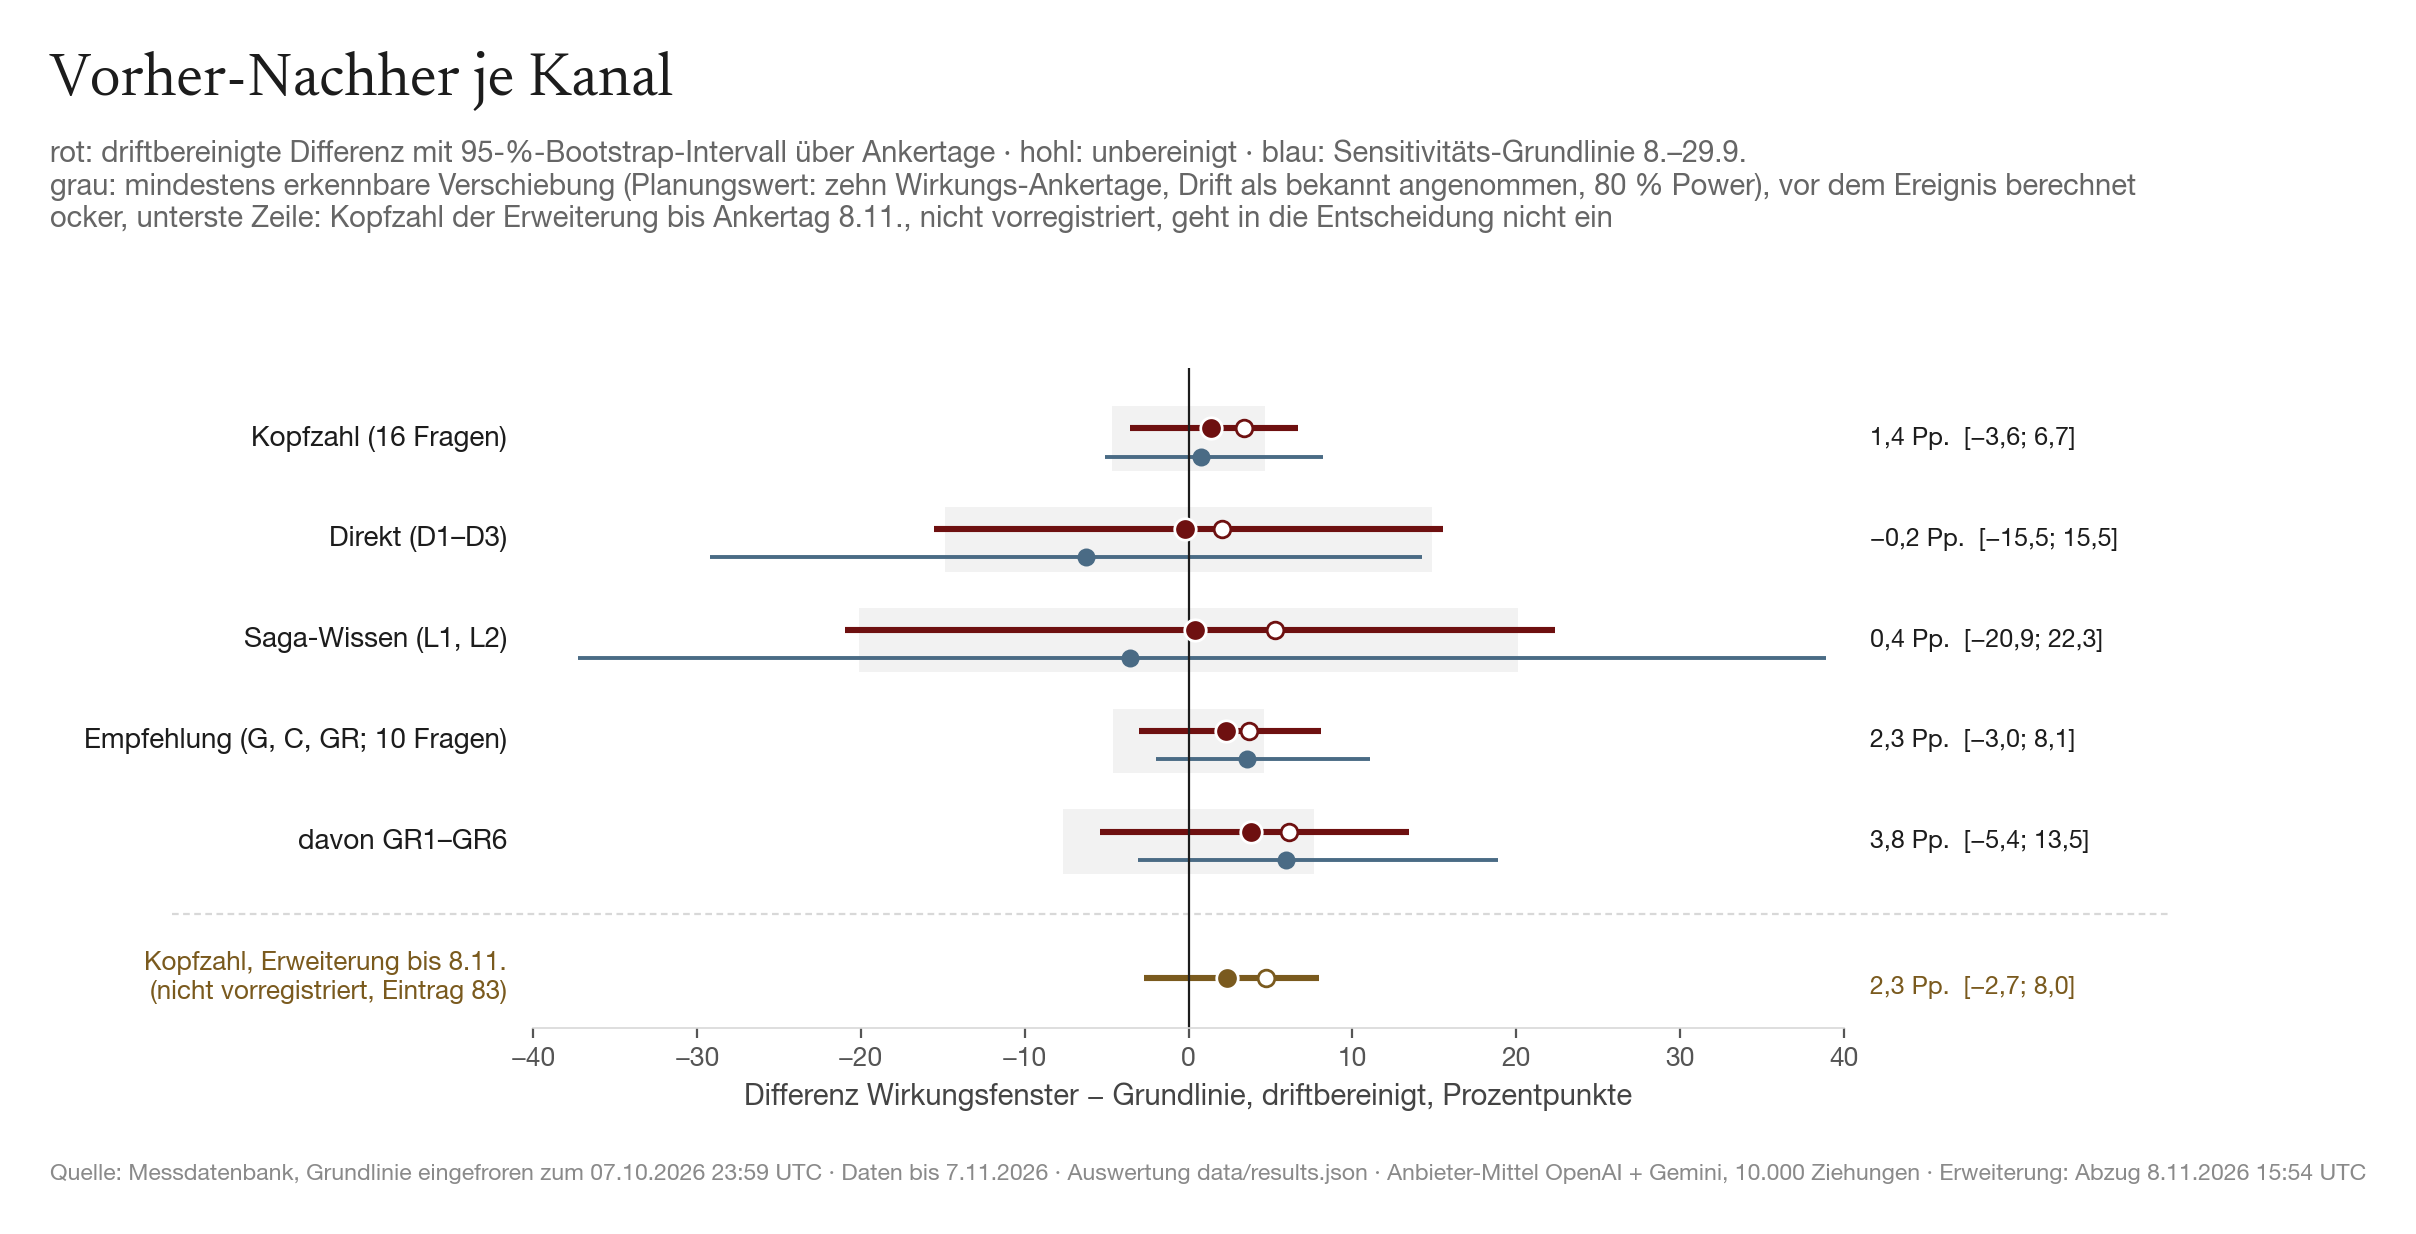
Auch in den Kanälen schließt kein Intervall die Null aus: Direkt −0,19 (−15,51 bis 15,53), Saga-Wissen +0,37 (−20,94 bis 22,34), Empfehlung +2,27 (−3,02 bis 8,11), davon GR1 bis GR6 +3,79 (−5,42 bis 13,48). Weder Direkt noch Empfehlung zeigen bis zum 5. November eine erste Abweichung; die Reihenfolge-Hypothese erhält keine Stütze, auch mit dem vorregistrierten Empfehlungs-Kanal GR1 bis GR6. Einen Aufwärtsalarm melden nur die Kopfzahl und die Trefferquote über alle Fragen, beide am 5. November, an einem Tag, für den nur OpenAI misst.
Claude auf claude.ai lag in der Grundlinienmessung am 7. Oktober im Mittel der drei Modelle bei 8,34 Prozent (Direkt 44,44, Saga-Wissen und Empfehlung 0,00) und an den 10 Ankertagen von 4,86 bis 9,03 Prozent; Empfehlungen nannten den Autor an keinem Tag. Diese Werte sind beschreibend.
Gegen die Sensitivitäts-Grundlinie ohne Vorab-Verfügbarkeit (8. bis 29. September) beträgt die Differenz der Kopfzahl +0,74 (−5,08 bis 8,22), mit den Bewertungsregeln vom 2. November in beiden Fenstern +2,77 (−2,37 bis 8,28), mit leeren Antworten als Lücke +1,70 (−3,27 bis 6,96) und ohne Änderung 4 +0,96 (−4,15 bis 6,36); alle diese Rechnungen führen zur selben Entscheidung. Werden leere Antworten als Fehlmessung gewertet, bleibt für Gemini ein Wirkungstag, und ein Intervall lässt sich nicht berechnen. Eine nicht vorregistrierte Erweiterung des Wirkungsfensters bis zum Ankertag 8. November, an dem auch Gemini wieder gemessen ist, ergibt +2,32 (−2,74 bis 7,95); entschieden wird allein mit der vorregistrierten Hauptanalyse. OpenAI ist an allen 10 Ankertagen des Wirkungsfensters vollständig gemessen, Gemini an 5.
1
Fragestellung und Vorregistrierung
Das Programm untersucht, wann und wie KI-Antwortmaschinen einen neuen Autor finden und zitieren. Bis Anfang Oktober 2026 gab es zum Autor und seinem Werk fast nur selbst veröffentlichte Nachweise. Mit dem Erscheinen des ersten Bandes entstehen erstmals Nachweise, die Dritte führen und maschinenlesbar bereitstellen: Händlerkataloge, Bibliotheksmetadaten, ISBN-Verzeichnisse.
Die erste Fassung der Vorregistrierung Q7 wurde am 5. September 2026 im Lückenregister erfasst, damals für einen Erscheinungstermin am 22. September (Eintrag 12). Am 15. September wurde der Termin öffentlich auf den 8. Oktober verschoben; die neu datierte Fassung wurde am 23. September erfasst (Eintrag 18), vor dem Ereignis. Die Datei der Vorregistrierung liegt seit dem 7. Oktober 2026 im Repositorium; ein datierter Vermerk vom 8. November 2026 hält dort die Erfassungsdaten fest, die ursprünglichen Angaben der Datei bleiben unverändert. Hypothese: Suchgestützte Modelle finden die neuen Fremdnachweise, sodass die Trefferquote im Direkt-Kanal (Fragen D1 bis D3) früher steigt als im Empfehlungs-Kanal (Fragen GR1 bis GR6), weil Empfehlungen zusätzlich Rezeptionssignale brauchen. Nullhypothese: kein Unterschied zwischen den Messfenstern. Kennzahl: die Kopfzahl je Ankertag und die drei Kanäle Direkt, Saga-Wissen und Empfehlung. Auswertung: Vorher-Nachher-Vergleich nach Abzug der Grundliniendrift, damit ein laufender Trend nicht als Wirkung gelesen wird. Unverändert bleiben die 16 festen Fragen und das Drei-Tage-Raster.
Am 7. Oktober 2026, einen Tag vor dem Ereignis, wurde die Vorregistrierung geändert (Fassung 1.1, Eintrag 36). Anlass waren Änderungen an der Messung, die die Festlegung berühren, das Anbieter-Panel nicht anzupassen. Begründet sind sie durch Messprobleme (Einträge zu Claude vom 16. September bis 6. Oktober und Eintrag 34); Zwischenergebnisse lagen der Änderung nicht zugrunde. Die Änderung hat vier Punkte:
1. Die primäre Auswertung stützt sich nur auf die beiden Anbieter, deren Panel seit dem 19. August unverändert ist: OpenAI mit Websuche und Gemini. Kopfzahl ist der einfache Mittelwert beider Anbieter je Ankertag, dazu die drei Kanäle. Die Grundlinie umfasst bei Gemini 10 Ankertage, bei OpenAI 6, weil die OpenAI-Messung vom 18. bis 27. September ausfiel (Eintrag 17). Hypothese, Nullhypothese und Auswertung bleiben unverändert.
2. Claude wird nur noch sekundär und beschreibend ausgewertet. Ab dem 7. Oktober misst das Programm mit dem jeweils neuesten Opus-Modell auf claude.ai in einem Inkognito-Chat mit Websuche (Eintrag 34). Die frühere Reihe aus drei Modellstufen ist damit nicht vergleichbar. Grundlinie der neuen Konfiguration ist eine einzige Messung am 7. Oktober außerhalb des Rasters, danach folgen die Ankertage ab dem 9. Oktober. Für Claude gibt es keine Signifikanzaussage.
3. Taschenbuch und gebundene Ausgabe waren schon ab dem 30. September bestellbar, das offizielle Erscheinen und das E-Book folgten am 8. Oktober. Deshalb wird zusätzlich eine Sensitivitäts-Grundlinie vom 8. bis 29. September ohne Vorab-Verfügbarkeit berichtet.
4. Die Korrektur des Bewertungsschemas vom 7. Oktober betrifft nur Claude-Zeilen (Eintrag 32), die Beschränkung der Verlaufsanzeige auf Ankertage betrifft die Anzeige; beides wirkt nicht auf die primäre Auswertung.
Punkt 4 ist durch eine zweite Änderung berichtigt, die am selben Tag vor dem Ereignis und ohne Kenntnis von Wirkungsdaten festgeschrieben wurde (Änderung 2, Fassung 1.2, Eintrag 38). Sie hat drei Teile:
1. Berichtigung zu Punkt 4: Eine weitere Korrektur des Bewertungsschemas betrifft auch OpenAI und Gemini (Eintrag 37). Das Schema führte als Kernfakt noch den alten Erscheinungstermin 22. September; seit dem 7. Oktober zählt der Termin unabhängig davon, ob eine Antwort den 22. September oder den 8. Oktober nennt. Nachbewertet wurden seit dem 15. September nur Antworten, deren gespeicherter Auszug von 500 Zeichen die Kernfakten selbst belegt: 8 Antworten von zwei auf drei Punkte. Weil die Grundlinie nur teilweise nachbewertet werden konnte, das Wirkungsfenster aber vollständig nach der neuen Regel bewertet wird, kann der punktbasierte Direkt-Kanal nach oben verzerrt sein. Die Grundlinie dieses Berichts enthält diese 8 und weitere Nachbewertungen vom selben Tag (Abschnitt 2).
2. Robustheits-Kennzahl: die Trefferquote, also der Anteil der Antworten, die den Autor richtig nennen (Bewertung über null), je Anbieter und Kanal. Sie hängt nicht an der Schwelle zwischen teilweiser und vollständiger Nennung. Ein Effekt im Direkt-Kanal sollte nur berichtet werden, wenn er in den Punkten und in der Trefferquote auftritt; diese Regel ist durch Änderung 3 ersetzt.
3. Einzelheiten der Auswertung: Drift, Effektschätzung und erste Abweichung wie in Abschnitt 3; letzter Ankertag im Wirkungsfenster ist der 5. November.
Eine dritte Änderung, ebenfalls am 7. Oktober vor jedem Wirkungsdatum festgeschrieben (Änderung 3, Fassung 1.3, Eintrag 39), ersetzt die Direkt-Regel aus Änderung 2. Anlass ist die Decke der Trefferquote im Direkt-Kanal: In der Grundlinie nennen im Mittel beider Anbieter 92,2 Prozent der Antworten den Autor richtig, ein Anstieg kann höchstens 7,8 Prozentpunkte betragen und liegt damit unter der mindestens erkennbaren Verschiebung (Abschnitt 4). Im Direkt-Kanal dient die Trefferquote seither nur der Vorzeichenprüfung; in allen anderen Kanälen bleibt sie volle Robustheits-Kennzahl.
Eine vierte Änderung wurde am 15. Oktober 2026 im laufenden Wirkungsfenster festgelegt, nach den Ankertagen 9., 12. und 15. Oktober, und ist als solche gekennzeichnet (Änderung 4, Fassung 1.4, Eintrag 50). Anlass war ein Fehler des Bewertungsschemas, der beim Lesen der Antworten auffiel: Das Schema verlangte den Namen des Autors als Anker, sodass eine Antwort, die das Buch richtig nennt, ohne den Autor zu nennen, null Punkte erhielt. Seither zählt auch der Buch- oder Reihentitel als Anker, wenn er nicht schon in der Frage steht; das gleichnamige Sachbuch eines anderen Autors bleibt eine Kollision ohne Punkte. Die Regel gilt rückwirkend für alle Zeilen seit dem 19. August. Sie ändert zwei Antworten, beide vom 12. Oktober zur Frage L1: Gemini von null auf zwei Punkte und Claude Opus von null auf zwei Punkte (nur beschreibend). In der Grundlinie ist keine Antwort betroffen, die Regel wirkt auf Grundlinie und Wirkungsfenster gleich. Weil Änderung 4 eine Gemini-Antwort im Wirkungsfenster ändert, berichtet Abschnitt 7 die Auswertung auch ohne sie.
Neben den vier Änderungen wurden am 7. Oktober vor dem Ereignis vier Festlegungen registriert. Claude wird ab dem 9. Oktober mit dem jeweils neuesten Modell der drei Familien Opus, Sonnet und Haiku gemessen; der Anbieterwert ist ihr Mittel (Eintrag 41). Auch die Grundlinienmessung am 7. Oktober umfasst alle drei Modelle, bei Haiku noch Haiku 4.5 (Einträge 45 und 49). Antworten, die einen ehrlichen Nichtfund der Suche melden, zählen null statt minus drei Punkte (Eintrag 42). Ein Verweis auf die Filmkritikerin Pauline Kael gilt als Namens-Kollision mit null Punkten; echte Angaben über den Autor in derselben Antwort werden wie üblich bewertet (Eintrag 43). Diese drei Festlegungen verändern die primäre Kennzahl nicht oder wirken in Grundlinie und Wirkungsfenster gleich, Eintrag 43 mit einer Einschränkung. Den zweiten Teil von Eintrag 43 setzt der Bewerter in der vorregistrierten Fassung, also vor den Regeln vom 2. November, enger um: Eine Antwort, die den Autor zutreffend beschreibt und sich am Ende gegen Pauline Kael abgrenzt, wertet er als Kollision mit null Punkten (Fehler 1 in Eintrag 71). Vor dem Ereignis betraf das bei OpenAI und Gemini nur eine Antwort (Gemini, 6. September, Frage D1), die am 7. Oktober nach dem Wortlaut nachbewertet wurde. Im Wirkungsfenster betrifft es 5 Antworten von Claude auf die Frage D1, in der Erweiterung 6; die Hauptanalyse folgt hier dem Bewerter, OpenAI und Gemini sind nicht betroffen (Abschnitt 6). Fällt OpenAI wegen eines erschöpften Kontingents aus, wird einmal innerhalb von 36 Stunden nachgemessen (Eintrag 44). Diese Festlegung wirkt nur im Wirkungsfenster, denn die Grundlinie enthält keine Nachmessung; so geht für OpenAI der 2. November ein (Abschnitt 2). Im Wirkungsfenster kamen drei Festlegungen hinzu. Seit dem 1. November gilt eine leere Antwort als fehlgeschlagene Messung (Eintrag 66), seit dem Ankertag 5. November wird die Frage dann im selben Lauf einmal wiederholt (Eintrag 70); leere Antworten vor dem 1. November gehen mit null Punkten ein. Am 2. November wurden vier Fehler der Bewertungsregeln behoben, rückwirkend für das Wirkungsfenster; die Messdatenbank trägt die neuen Regeln seit der Messung vom 5. November (Eintrag 71). Die Hauptanalyse bewertet das Wirkungsfenster durchgehend nach den vorregistrierten Regeln, mit dem Bewerter in der Fassung vor dem 2. November: Sie setzt die zehn rückwirkend geänderten Antworten zurück, und die 64 gewerteten Antworten vom 5. November (16 von OpenAI, 48 von Claude) wurden am Volltext nach den vorregistrierten Regeln neu bewertet. Davon weicht eine Antwort von Claude ab, die 16 Antworten von OpenAI sind unter beiden Regeln gleich bewertet; zusammen setzt die Hauptanalyse elf Antworten zurück. Eine Sensitivitätsrechnung wendet die neuen Regeln auch auf die Grundlinie an (Abschnitt 7). Bei Claude ist die Websuche aktiviert, aber nicht erzwungen; ob gesucht wurde, wird seit dem 2. November je Antwort gespeichert (Eintrag 72). Nach dem Ende des Wirkungsfensters kamen am 8. November eine Nachhol-Regel für Gemini (Eintrag 82) und die nicht vorregistrierte Erweiterung bis zum Ankertag 8. November hinzu (Eintrag 83, Abschnitt 7). Abschnitt 8 fasst alle Abweichungen vom Plan zusammen.
2
Daten und Fenster
Grundlage der Hauptanalyse sind zwei Abzüge der Messdatenbank. Der Grundlinien-Abzug wurde am 7. Oktober 2026 mit dem Stichtag 7. Oktober, 23:59 UTC, eingefroren; die Originaldateien bleiben unverändert. Zeilen mit einem Zeitstempel vor dem Stichtag, die erst später eintreffen, werden getrennt als Nachtrag gespeichert, Änderungen an eingefrorenen Zeilen bis zum 8. Oktober, 12:00 UTC, getrennt als Korrektur; spätere Änderungen werden nur gemeldet. Nachgetragen wurden die 48 Antworten der Claude-Grundlinienmessung vom 7. Oktober (16 je Modell), als Korrektur übernommen 18 Nachbewertungen von OpenAI und Gemini (8 aus Eintrag 37, 9 aus Eintrag 42, eine aus Eintrag 43) und 3 der älteren Claude-Reihe. Auf Grundlinien-Ankertage fallen davon 3 Antworten von Gemini (Antworten je Tag: 21. September 1, 3. Oktober 2), auf Ankertage der Driftbasis 3 (19. August, 25. August, 6. September). Er enthält 1.504 Antwortzeilen von OpenAI und Gemini aus der Zeit vom 19. August bis 6. Oktober, 1.008 Antwortzeilen der älteren Claude-Reihe, die Laufzeitpunkte der Messläufe und 35 Einträge des Lückenregisters. Der zweite Abzug wurde am 8. November 2026, 04:11 UTC, mit dem Stichtag 7. November, 23:59 UTC, eingefroren. Er enthält 1.824 Antwortzeilen von OpenAI und Gemini, 1.536 Antwortzeilen von Claude, 84 Messläufe und 78 Einträge des Lückenregisters. Gegen diesen Abzug ist der Grundlinienbestand vollständig und unverändert: von 1.504 Zeilen von OpenAI und Gemini und 1.056 Claude-Zeilen fehlen 0, geändert sind 0. Für die nicht vorregistrierte Erweiterung (Abschnitt 7) wurde ein dritter Abzug am 8. November 2026, 15:54 UTC, mit dem Stichtag 8. November, 23:59 UTC, gezogen, nachdem alle Messungen dieses Tages vorlagen. Er enthält 1.856 Antwortzeilen von OpenAI und Gemini, 1.584 von Claude, 85 Messläufe und 82 Einträge des Lückenregisters. Bis zum 7. November stimmt er mit dem zweiten Abzug überein (0 fehlende, 0 geänderte Zeilen); neu sind die 32 Antwortzeilen von OpenAI und Gemini und die 48 von Claude vom 8. November.
Jeder Anbieter beantwortet dieselben 16 Fragen: drei nennen Autor oder Werk (Direkt, D1 bis D3), zwei fragen nach Begriffen aus dem Werk (Saga-Wissen, L1 und L2), zehn nennen weder Autor noch Werk (Empfehlung: zwei Genre-Fragen, zwei Vergleichsfragen, sechs Empfehlungsfragen GR1 bis GR6), eine fragt nach dem Forschungsprogramm (R1). Die Kanäle folgen der Einteilung des Messdienstes; R1 geht nur in die Kopfzahl ein. Die Vorregistrierung nennt als Empfehlungs-Kanal die Fragen GR1 bis GR6. Abweichend davon umfasst der Empfehlungs-Kanal der Auswertung zehn Fragen; das wurde am 7. Oktober vor dem Ereignis im Auswertungscode festgelegt, damit die Kanäle der Einteilung des Messdienstes folgen, aber nicht registriert. Der vorregistrierte Kanal GR1 bis GR6 wird deshalb überall mitberichtet, auch für die Reihenfolge-Hypothese. Die Fragen G1, G2, C1 und C2 haben an allen Ankertagen null Punkte; der Kanal aus zehn Fragen ist deshalb an jedem Anbieter-Tag genau das 0,6-Fache des Kanals GR1 bis GR6, in Punkten wie in der Trefferquote. Bewertet wird regelbasiert von minus drei bis plus drei.
Ausgewertet werden nur die Ankertage des Drei-Tage-Rasters, das am 19. August 2026 beginnt. OpenAI und Gemini haben zwischen dem 20. August und dem 4. Oktober auch an 30 Zwischentagen gemessen; diese Messungen bleiben unberücksichtigt (Eintrag 26).
| Fenster | Zeitraum | Ankertage | vollständig OpenAI | vollständig Gemini |
|---|---|---|---|---|
| Driftbasis vor der Grundlinie | 19.08.–07.09.2026 | 7 | 7 | 7 |
| Grundlinie | 08.09.–07.10.2026 | 10 | 6 | 10 |
| Sensitivitäts-Grundlinie | 08.09.–29.09.2026 | 7 | 3 | 7 |
| Wirkungsfenster | 08.10.–07.11.2026 | 10 | 10 | 5 |
| Beobachtung verzögerter Wirkung | 08.11.2026–06.01.2027 | 20 | läuft | läuft |
| Erweiterung, nicht vorregistriert | 08.10.–08.11.2026 | 11 | 11 | 6 |
Die Ankertage des Wirkungsfensters sind der 9., 12., 15., 18., 21., 24., 27. und 30. Oktober sowie der 2. und 5. November. Der Erscheinungstag selbst ist kein Ankertag. Die nicht vorregistrierte Erweiterung (Abschnitt 7) zählt zusätzlich den 8. November zum Wirkungsfenster, nach der Vorregistrierung der erste Ankertag der Beobachtung verzögerter Wirkung. An den vier Grundlinien-Ankertagen 18., 21., 24. und 27. September lieferte OpenAI ausschließlich Fehlerzeilen; diese Tage gehen für OpenAI nicht ein, eine Lücke ist kein Nullwert. Im Wirkungsfenster hat OpenAI an allen 10 Ankertagen 16 Messwerte; am 2. November lehnte die Schnittstelle zunächst alle Fragen ab (Kontingent erschöpft), die Nachmessung nach der Nachhol-Regel lag innerhalb der Frist von 36 Stunden (Einträge 44 und 68). Gemini lehnte an den Ankertagen 24. Oktober, 27. Oktober, 30. Oktober, 2. November und 5. November alle Fragen ab, weil das Guthaben des Messkontos aufgebraucht war (Einträge 58, 61, 64, 67 und 74); nachgemessen wurde nicht, und diese Tage werden auch nachträglich nicht nachgemessen, weil die Nachhol-Regel für Gemini erst ab dem 8. November gilt (Eintrag 82). Für Gemini gehen damit 5 Wirkungs-Ankertage ein, die Kopfzahl ist an 5 Ankertagen definiert, die übrigen 5 sind Basiswechsel. Die Effektschätzung je Anbieter bleibt davon formal unberührt, weil jede Anbieter-Differenz gegen die eigene Grundlinie gerechnet wird; die Gemini-Differenz stützt sich aber nur auf die erste Hälfte des Fensters. Messungen an Zwischentagen gab es im Wirkungsfenster nicht.
3
Methoden
Je Ankertag, Anbieter und Frage zählt eine Antwort, nach der Regel des Programms vom 4. September 2026 (Lückenregister, Eintrag 11): Eine Fehlerzeile verliert immer; unter den übrigen gewinnt die Antwort, deren Zeitstempel dem planmäßigen Laufzeitpunkt am nächsten liegt, bei Gleichstand die frühere. Im Grundlinien-Abzug gibt es an Ankertagen keine Doppelzeilen. Der Tageswert eines Anbieters ist die Punktsumme geteilt durch das Maximum (Zahl der Fragen mal drei), als Prozent, getrennt für alle 16 Fragen und für jeden Kanal. Ein Anbieter-Tag zählt nur, wenn alle 16 Fragen einen Messwert haben. Die Kopfzahl eines Ankertages ist der Mittelwert von OpenAI und Gemini und nur an Tagen definiert, an denen beide gemessen haben; Tage mit nur einem Anbieter werden als Basiswechsel gekennzeichnet und nicht gemittelt.
Die erste Fassung der Vorregistrierung legt Vorher-Nachher-Vergleich und Abzug der Grundliniendrift fest, aber keine Einzelheiten. Diese wurden am 7. Oktober 2026 vor dem Ereignis im Auswertungscode festgelegt und mit Änderung 2 registriert.
Drift. Je Anbieter und Kanal wird eine Gerade nach der Methode der kleinsten Quadrate über alle Ankertage vom 19. August bis zum Ende der Grundlinie angepasst (OpenAI 13, Gemini 17 Ankertage) und in das Wirkungsfenster fortgeschrieben. Der längere Zeitraum stabilisiert die Steigung, vor allem bei OpenAI mit nur sechs Grundlinientagen. Das Niveau der Vergleichsbasis bleibt die Grundlinie.
Differenz. Je Anbieter ist die driftbereinigte Differenz das mittlere Residuum im Wirkungsfenster minus das mittlere Residuum in der Grundlinie, beide gegen dieselbe Gerade. Für die Kopfzahl und jeden Kanal wird das Mittel der beiden Anbieter-Differenzen berichtet; so gehen alle registrierten Grundlinientage beider Anbieter ein, ohne dass sich die Basis von Tag zu Tag ändert. Die unbereinigte Differenz der Mittelwerte steht daneben.
Intervall. Das 95-Prozent-Intervall stammt aus einem Bootstrap über Ankertage mit 10.000 Ziehungen und festem Startwert. Gezogen wird mit Zurücklegen, getrennt für die Driftbasis vor der Grundlinie, die Grundlinie und das Wirkungsfenster und getrennt je Anbieter; die Gerade wird in jeder Ziehung neu angepasst. Die Nullhypothese gilt als verworfen, wenn das Intervall der driftbereinigten Differenz die Null nicht enthält.
Driftprüfung. Ob sich die Grundlinie gegenüber der Zeit davor verschoben hat, prüft eine tabellarische CUSUM-Karte mit k = 0,5 und h = 5 Standardabweichungen, wie im Programm üblich, mit Referenz aus den sieben Ankertagen vom 19. August bis 6. September.
Erste Abweichung. Für die Reihenfolge-Hypothese wird je Kanal ab dem ersten Ankertag des Wirkungsfensters ein einseitiger CUSUM auf den driftbereinigten Residuen gebildet, standardisiert mit deren Standardabweichung in der Grundlinie (k = 0,5, h = 5). Der erste Ankertag mit Alarm gilt als Zeitpunkt der ersten signifikanten Abweichung. Weil Kanäle mit wenigen Fragen in der Grundlinie fast ohne Streuung sein können, wird die Standardabweichung nach unten auf einen halben Bewertungspunkt einer Anbieter-Messung begrenzt (Kopfzahl 1,04, Direkt 5,56, Saga-Wissen 8,33, Empfehlung 1,67, GR1 bis GR6 2,78 Prozentpunkte). Sekundär wird der erste Ankertag berichtet, an dem das Residuum die 95-Prozent-Prognosegrenze der Driftgeraden überschreitet. Die Hypothese gilt als gestützt, wenn der Direkt-Kanal im Fenster einen Aufwärtsalarm meldet, vor dem Empfehlungs-Kanal oder ohne dass dieser alarmiert; alarmiert keiner der beiden, erhält sie keine Stütze. Das Urteil wird mit dem Empfehlungs-Kanal aus zehn Fragen gebildet und mit dem vorregistrierten Kanal GR1 bis GR6 wiederholt (Abschnitt 2).
Mindestens erkennbare Verschiebung. Aus der Streuung um die Driftgerade folgt, welche Verschiebung bei zehn vollständigen Wirkungs-Ankertagen je Anbieter mit 80 Prozent Power (zweiseitig, 5 Prozent) erkennbar ist: Kopfzahl 4,68 Prozentpunkte, Direkt 14,84, Saga-Wissen 20,12, Empfehlung 4,61, GR1 bis GR6 allein 7,68. Diese Werte dienen der Planung; sie wurden am 7. Oktober vor dem Ereignis mit der um die Einträge 42 und 43 korrigierten Grundlinie berechnet und behandeln die Drift als bekannt. Gemini hat im Wirkungsfenster nur 5 vollständige Ankertage (Abschnitt 2). Mit der Unsicherheit der Driftgeraden und den tatsächlich gemessenen Wirkungstagen je Anbieter liegt die mindestens erkennbare Verschiebung bei 7,32 Prozentpunkten für die Kopfzahl, 21,93 im Direkt-Kanal, 31,12 für Saga-Wissen, 7,96 für Empfehlung und 13,52 für GR1 bis GR6, gerechnet als 2,8-fache Bootstrap-Standardabweichung der driftbereinigten Schätzung; diese Werte sind nicht vorregistriert.
Trefferquote. Als Robustheits-Kennzahl (Änderung 2) wird je Anbieter-Tag und Kanal der Anteil der Antworten mit einer Bewertung über null berechnet und mit demselben Verfahren ausgewertet: Grundlinie, Sensitivitäts-Grundlinie, Driftgerade, driftbereinigte Differenz mit Bootstrap-Intervall und CUSUM für die erste Abweichung (Untergrenze der Standardabweichung: eine halbe Antwort einer Anbieter-Messung). Im Direkt-Kanal gilt Änderung 3 (Eintrag 39): Ein Effekt in Punkten wird berichtet, wenn sein Intervall die Null ausschließt und der Schätzwert der Trefferquoten-Differenz dasselbe Vorzeichen hat; ein Schätzwert von null zählt nicht als gleiches Vorzeichen. Widerspricht das Vorzeichen, gilt der Effekt als nicht belastbar. In den übrigen Kanälen gilt ein Effekt als robust, wenn die Intervalle der Punkt-Differenz und der Trefferquoten-Differenz beide die Null ausschließen und dasselbe Vorzeichen haben. Mindestens erkennbare Verschiebung der Trefferquote: alle Fragen 4,86 Prozentpunkte, Direkt 15,45, Saga-Wissen 23,20, Empfehlung 4,61, GR1 bis GR6 7,68. Änderung 3 nennt für den Direkt-Kanal 15,7, den Wert vor den Korrekturen der Einträge 42 und 43 vom selben Tag. Im Empfehlungs-Kanal vergeben die Antworten bisher nur null oder drei Punkte; dort sind Trefferquote und Punktwert in der Grundlinie identisch.
Claude geht nur beschreibend ein: Tageswert und Kanäle der Grundlinienmessung am 7. Oktober und jedes späteren Ankertages, dazu die Differenz zur Grundlinienmessung ohne Intervall. Der Tageswert ist das einfache Mittel der drei Modelle (Eintrag 41). Gezählt wird je Tag und Modell die früheste Messung mit Messwerten.
4
Grundlinie und Ergebnis der Kopfzahl
| Kanal | OpenAI | Gemini | Mittel beider | Tage mit beiden |
|---|---|---|---|---|
| Kopfzahl (16 Fragen) | 23,96 (3,42) · 6 | 20,94 (6,56) · 10 | 22,45 | 22,31 (4,71) · 6 |
| Direkt (D1–D3) | 81,48 (13,46) · 6 | 80,00 (21,47) · 10 | 80,74 | 80,56 (13,94) · 6 |
| Saga-Wissen (L1, L2) | 61,11 (17,21) · 6 | 15,00 (24,15) · 10 | 38,05 | 38,89 (17,21) · 6 |
| Empfehlung (10 Fragen) | 1,67 (4,08) · 6 | 6,00 (5,16) · 10 | 3,83 | 3,33 (4,08) · 6 |
| davon GR1–GR6 | 2,78 (6,80) · 6 | 10,00 (8,61) · 10 | 6,39 | 5,56 (6,81) · 6 |
Die Driftgerade der Kopfzahl steigt bei Gemini um 0,203 Prozentpunkte je Tag (95-Prozent-Intervall −0,006 bis 0,413, 17 Ankertage) und ist bei OpenAI flach (−0,019; −0,174 bis 0,137; 13 Ankertage). Allein aus der fortgeschriebenen Drift ergibt sich an den gemessenen Wirkungstagen ein Unterschied der Kopfzahl von 2,01 Prozentpunkten im Mittel beider Anbieter (Gemini 4,58 an 5 Tagen, OpenAI −0,56 an 10 Tagen), im Direkt-Kanal von 2,23 und im Empfehlungs-Kanal von 1,40; ohne Driftabzug würde er als Wirkung gelesen. Beide Steigungsintervalle der Kopfzahl und alle Steigungsintervalle der Kanäle enthalten die Null. Die CUSUM-Driftprüfung gegen die Referenz vom 19. August bis 6. September meldet einen Alarm: Gemini im Kanal Saga-Wissen, aufwärts, am 3. Oktober. Für OpenAI und für die übrigen Kanäle meldet sie keinen.
| Kanal | OpenAI | Gemini | Mittel beider | Sensitivität 8.–29.9. |
|---|---|---|---|---|
| alle 16 Fragen | 27,08 (3,23) · 6 | 23,75 (6,45) · 10 | 25,41 | 24,25 |
| Direkt (D1–D3) | 94,44 (13,61) · 6 | 90,00 (22,50) · 10 | 92,22 | 92,85 |
| Saga-Wissen (L1, L2) | 66,67 (25,82) · 6 | 15,00 (24,15) · 10 | 40,84 | 36,91 |
| Empfehlung (10 Fragen) | 1,67 (4,08) · 6 | 6,00 (5,16) · 10 | 3,83 | 2,85 |
| davon GR1–GR6 | 2,78 (6,80) · 6 | 10,00 (8,61) · 10 | 6,39 | 4,76 |
Im Direkt-Kanal nennen in der Grundlinie im Mittel beider Anbieter 92,2 Prozent der Antworten den Autor richtig, über alle Antworten gezählt 44 von 48 (91,67 Prozent). Bis zur Obergrenze bleiben 7,8 Prozentpunkte, weniger als die mindestens erkennbare Verschiebung von 15,45.
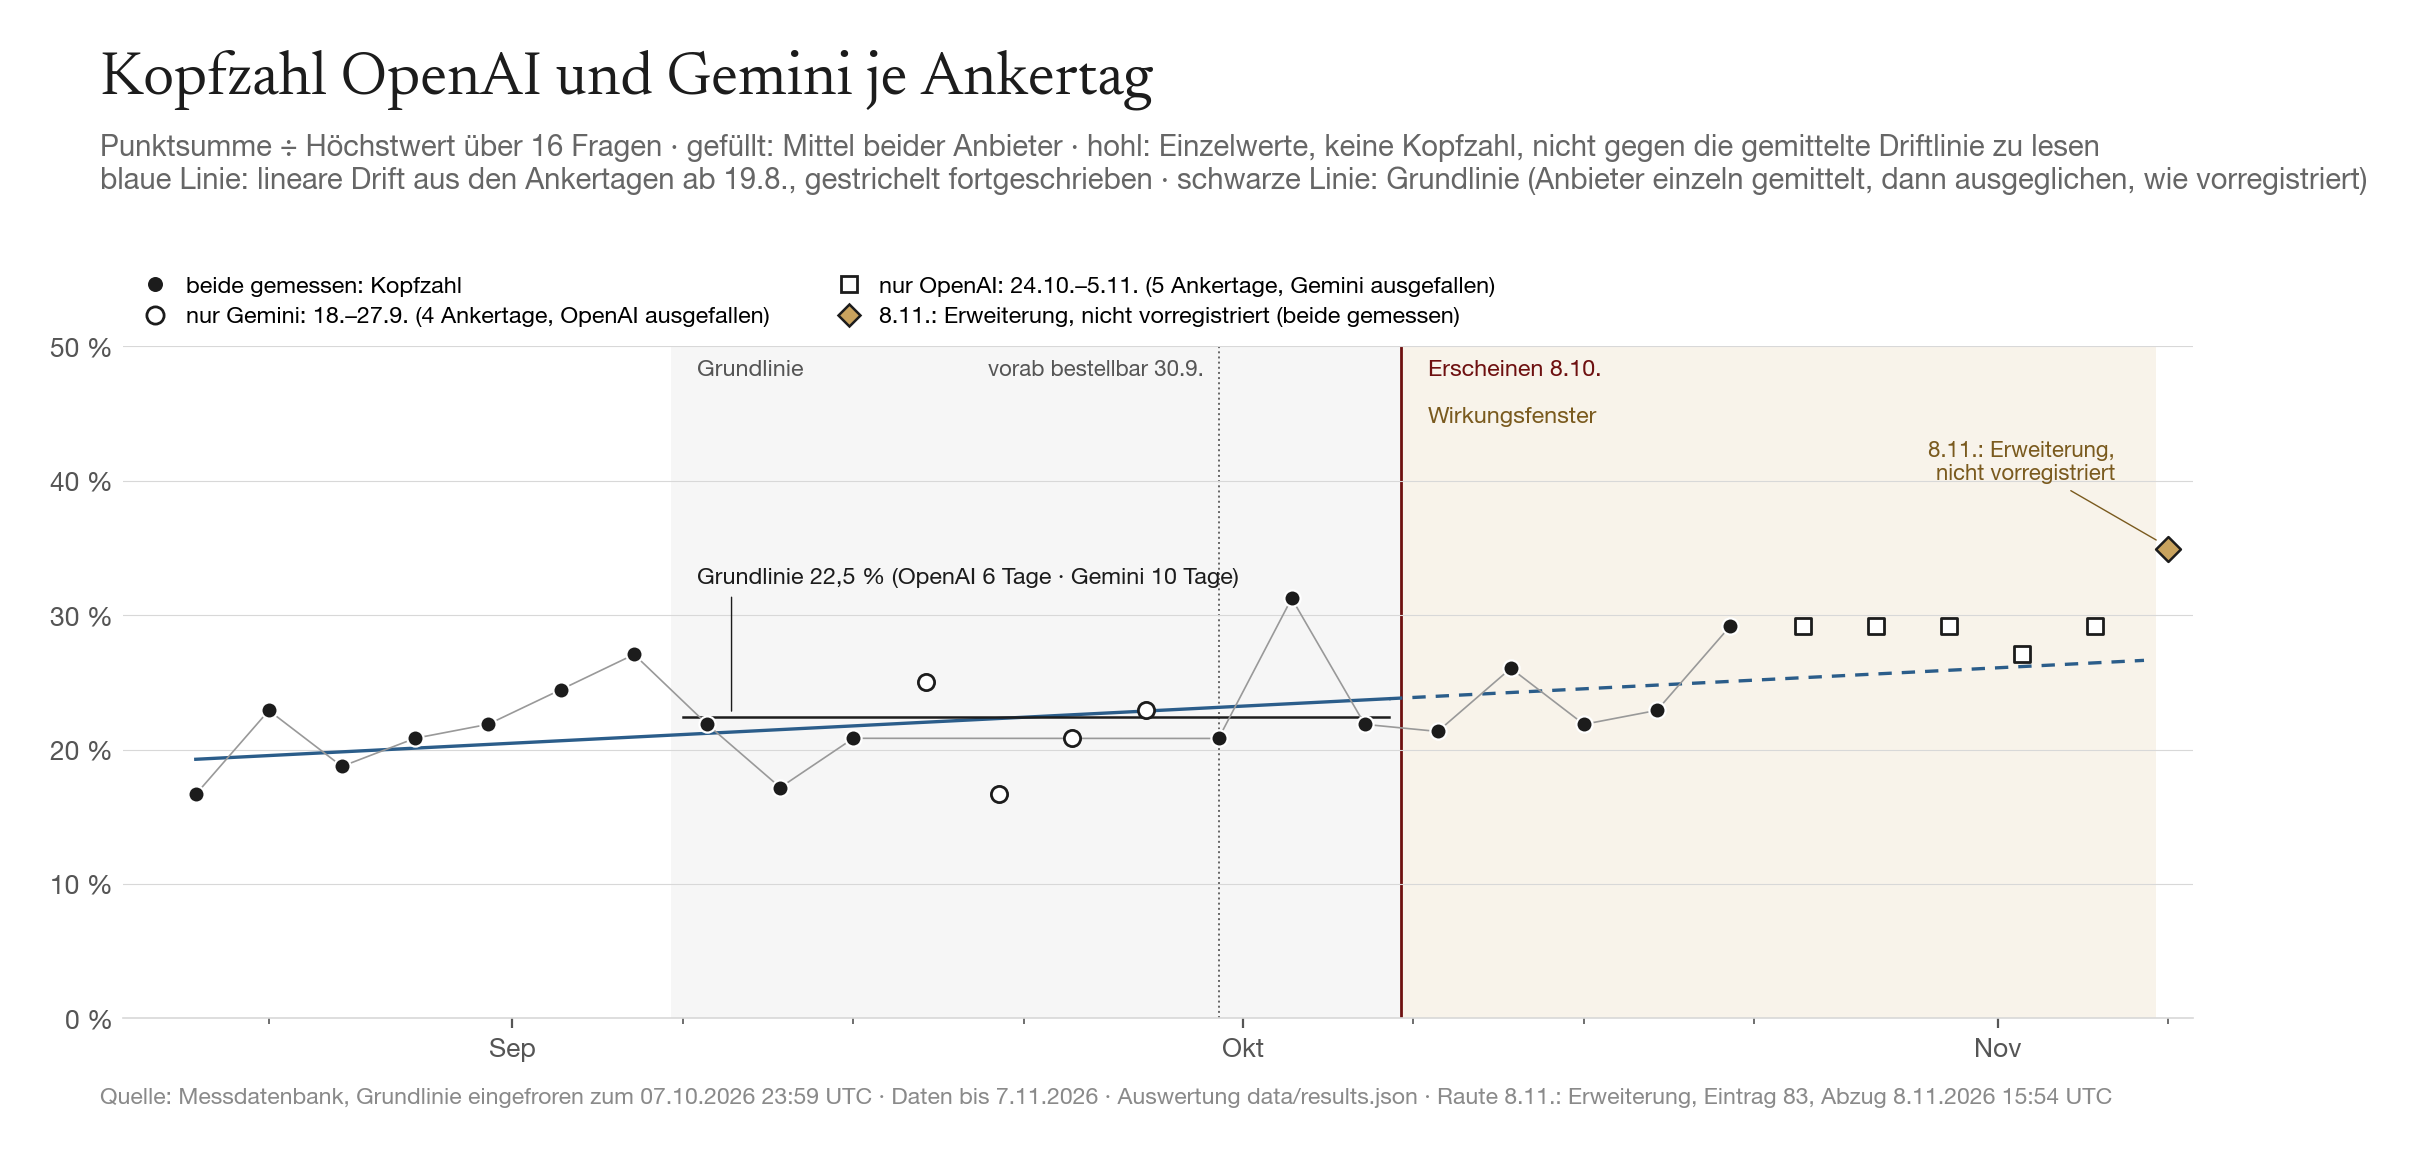
An den 5 Ankertagen mit beiden Anbietern lag die Kopfzahl bei 21,35 (09.10.), 26,05 (12.10.), 21,88 (15.10.), 22,92 (18.10.), 29,17 (21.10.), im Mittel 24,27 Prozent. An den 5 folgenden Ankertagen misst nur OpenAI (29,17, 29,17, 29,17, 27,08, 29,17); für diese Tage ist keine Kopfzahl definiert. OpenAI lag im Wirkungsfenster im Mittel bei 25,62 Prozent (10 Tage), Gemini bei 26,04 (5 Tage). Driftbereinigt beträgt die Differenz bei OpenAI +2,22 Prozentpunkte (−4,82 bis 8,78), bei Gemini +0,53 (−6,33 bis 8,84), im Mittel +1,38 (−3,59 bis 6,68). Unbereinigt sind es +1,67, +5,10 und im Mittel +3,38 (0,05 bis 6,93). Das Intervall der bereinigten Differenz enthält die Null; die Nullhypothese wird nicht verworfen. Das Intervall der unbereinigten Differenz liegt knapp über null; ohne Änderung 4 enthält es die Null (Abschnitt 7). Eine zusätzliche, nicht vorregistrierte Prüfung mit 200 weiteren Startwerten des Zufallsgenerators zeigt, wie knapp das ist: Die Untergrenze des unbereinigten Intervalls reicht von −0,07 bis 0,17 (im Mittel 0,05) und liegt bei 157 der 200 Startwerte über null. Ob das unbereinigte Intervall die Null ausschließt, hängt bei 10.000 Ziehungen also vom Startwert ab. Das bereinigte Intervall enthält die Null bei jedem Startwert (Untergrenze −3,63 bis −3,31, Obergrenze 6,44 bis 6,88). Der Abstand zwischen unbereinigter und bereinigter Differenz (2,00 Prozentpunkte) ist bis auf Rundung die an den gemessenen Wirkungstagen fortgeschriebene Drift (2,01); maßgeblich ist nach der Vorregistrierung die bereinigte Differenz. Der einseitige CUSUM der Kopfzahl alarmiert am 5. November aufwärts. Die Residuen reichen an den Tagen mit beiden Anbietern von −2,65 bis 4,09 und an den Tagen mit nur OpenAI von 3,88 bis 6,02 Prozentpunkten; der Alarm fällt damit mit dem Basiswechsel zusammen (Einordnung in Abschnitt 7). Die 95-Prozent-Prognosegrenze überschreitet kein Tag.
5
Kanäle und Hypothese Direkt vor Empfehlung
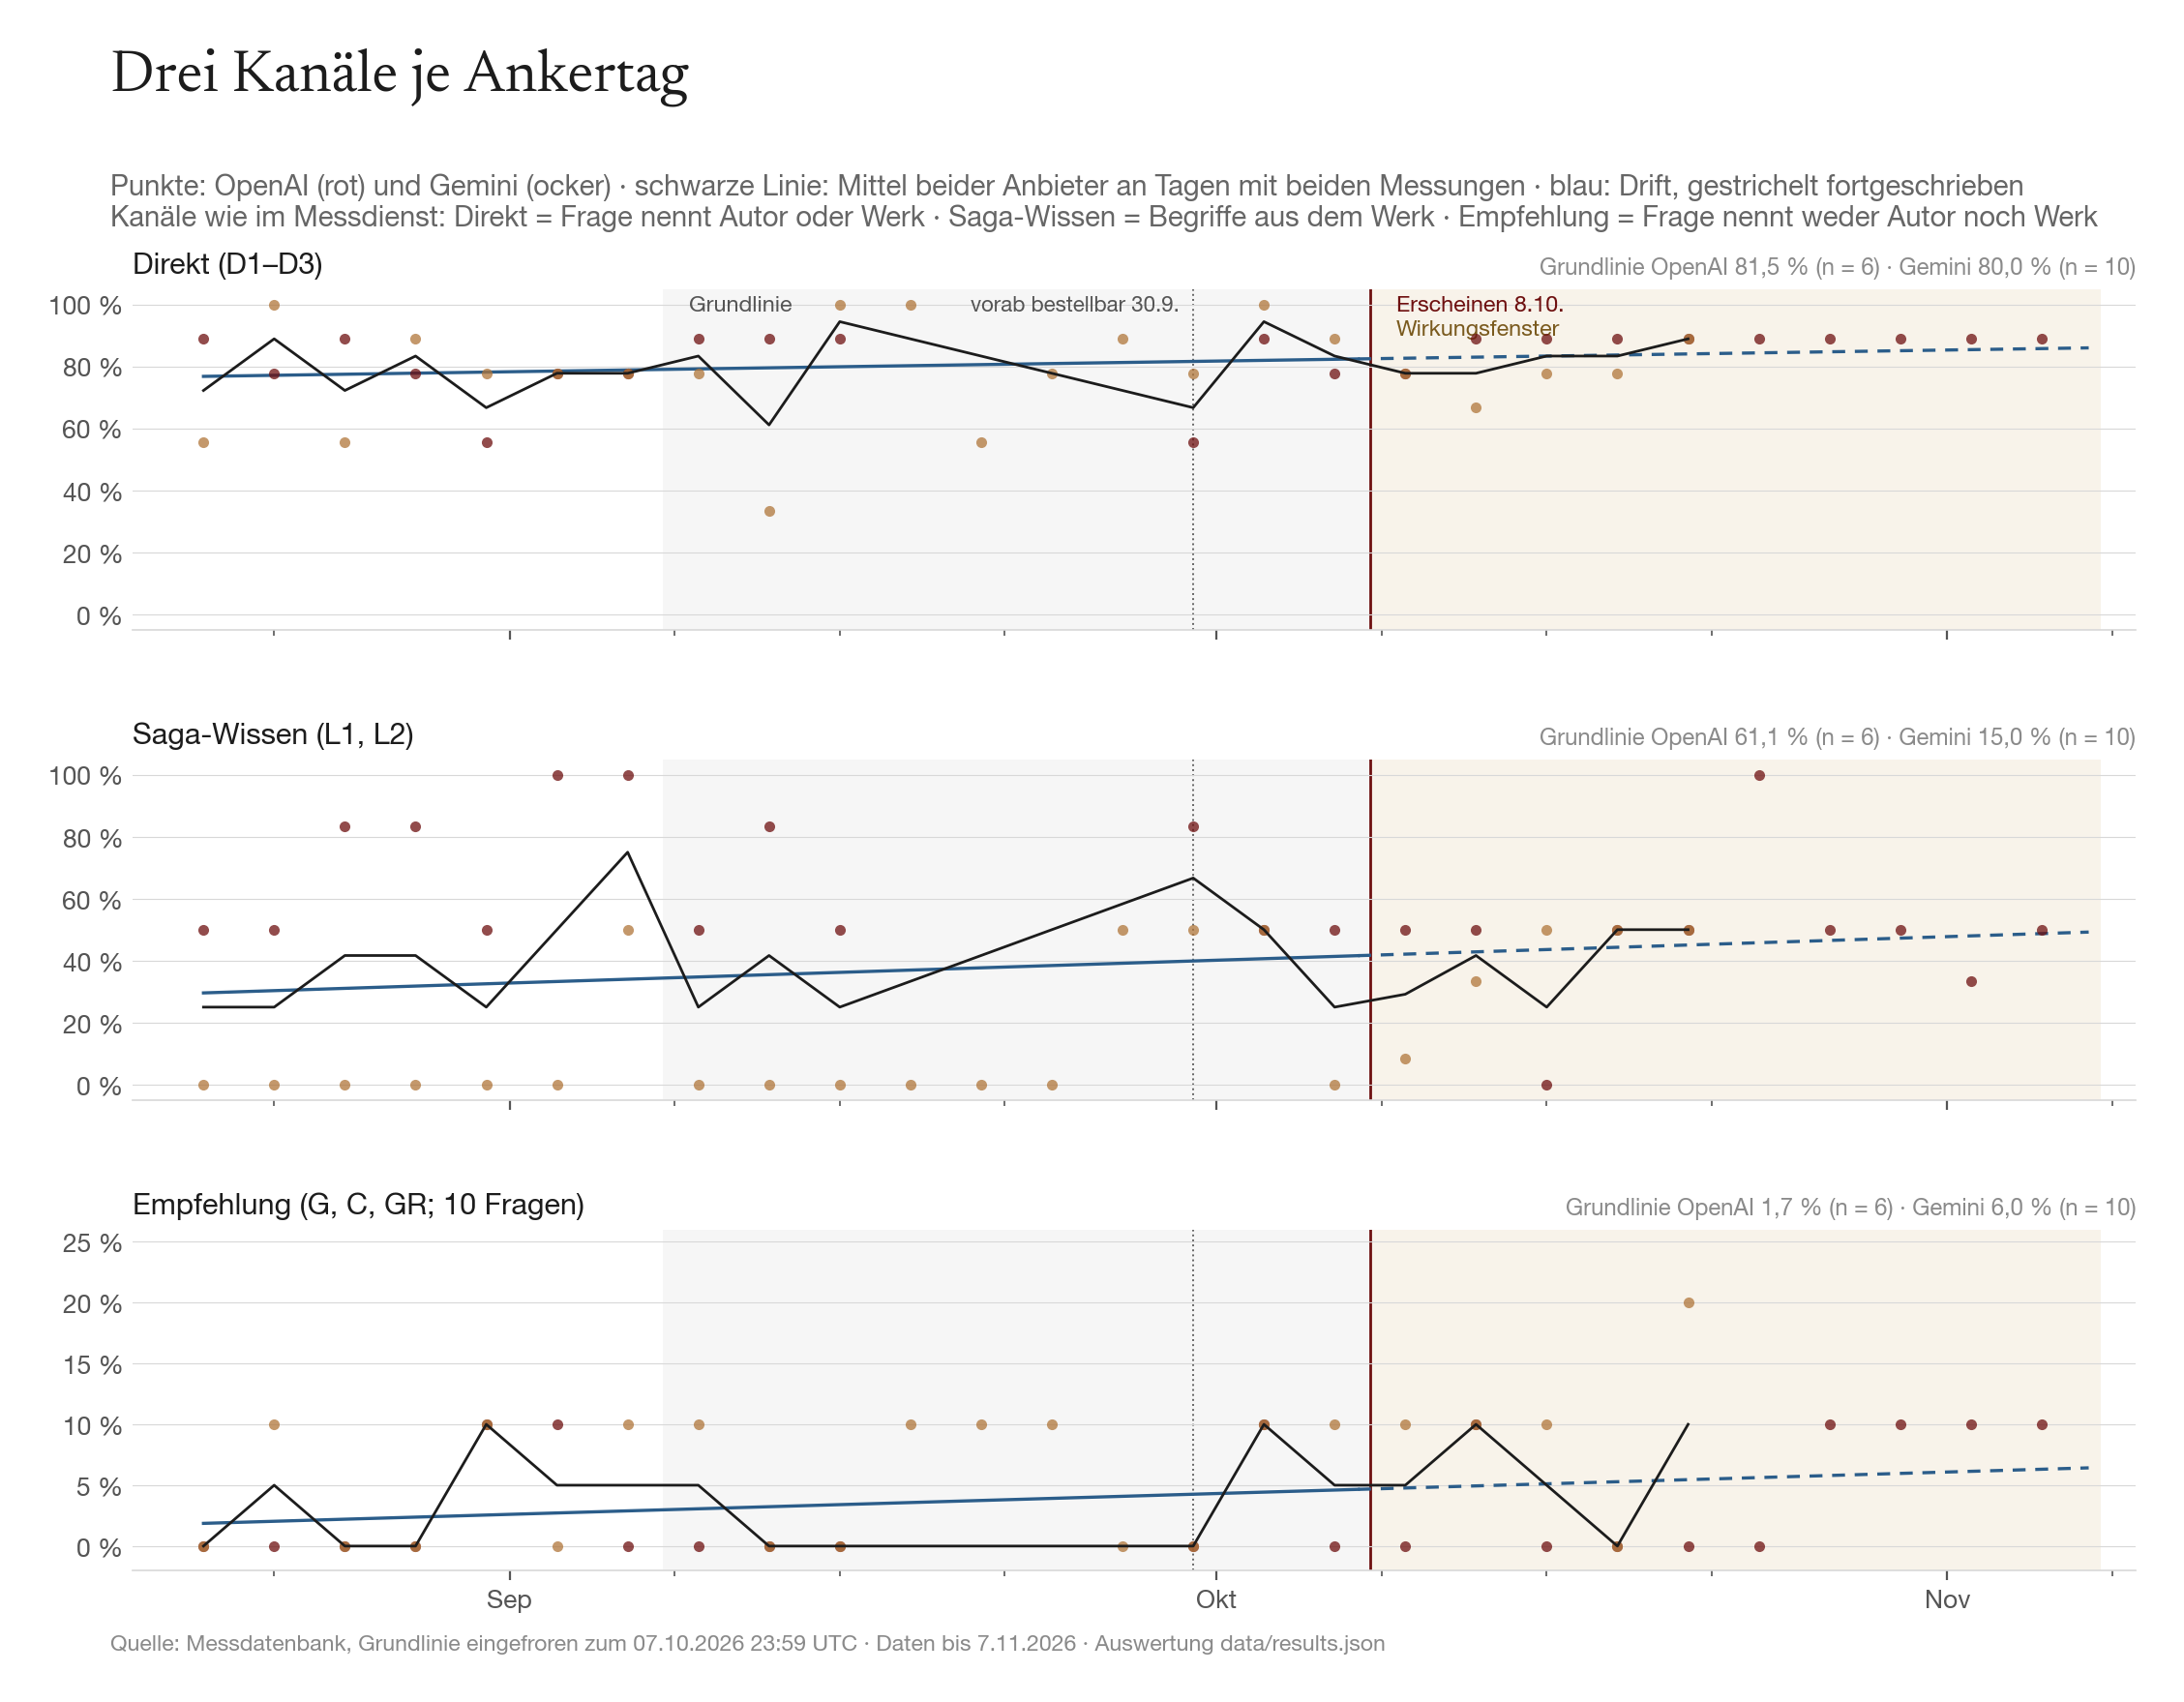
Spannweite der Kanäle an den Ankertagen des Wirkungsfensters, Prozent der höchstmöglichen Bewertung: OpenAI (10 Tage): Direkt 77,78 bis 88,89 (Mittel 87,78), Saga-Wissen 0,00 bis 100,00 (Mittel 48,33), Empfehlung 0,00 bis 10,00 (Mittel 5,00); Gemini (5 Tage): Direkt 66,67 bis 88,89 (Mittel 77,78), Saga-Wissen 8,33 bis 50,00 (Mittel 38,33), Empfehlung 0,00 bis 20,00 (Mittel 10,00). Der Kanal Saga-Wissen hat nur zwei Fragen und springt deshalb in Schritten von bis zu 50 Prozentpunkten. Im Empfehlungs-Kanal haben alle Antworten über null die volle Punktzahl; 10 Prozent entsprechen damit einer der zehn Antworten. OpenAI erreicht dort höchstens 10, Gemini höchstens 20 Prozent.
| Kanal | Differenz | 95-%-Intervall | unbereinigt | erster Alarm | erste Überschreitung |
|---|---|---|---|---|---|
| Kopfzahl | +1,38 | [−3,59; 6,68] | +3,38 | 05.11. | keiner |
| Direkt | −0,19 | [−15,51; 15,53] | +2,04 | keiner | keiner |
| Saga-Wissen | +0,37 | [−20,94; 22,34] | +5,27 | keiner | keiner |
| Empfehlung | +2,27 | [−3,02; 8,11] | +3,67 | keiner | keiner |
| davon GR1–GR6 | +3,79 | [−5,42; 13,48] | +6,12 | keiner | keiner |
Keiner der beiden für die Reihenfolge-Hypothese maßgeblichen Kanäle alarmiert im Wirkungsfenster, weder nach CUSUM noch nach der Prognosegrenze; die Hypothese, dass der Direkt-Kanal vor dem Empfehlungs-Kanal reagiert, erhält damit keine Stütze. Mit dem vorregistrierten Empfehlungs-Kanal GR1 bis GR6 lautet das Urteil gleich. Alle Schätzwerte liegen unter den Planungswerten der mindestens erkennbaren Verschiebung des jeweiligen Kanals (Kopfzahl 4,68, Direkt 14,84, Saga-Wissen 20,12, Empfehlung 4,61, GR1 bis GR6 7,68) und unter den Werten mit Drift-Unsicherheit (Abschnitt 3); der größte Betrag ist 3,79 Prozentpunkte. Eine Wirkung dieser Größe kann das Design nicht von null unterscheiden. Die Kanal-Differenzen von OpenAI und Gemini haben im Direkt-Kanal entgegengesetzte Vorzeichen (OpenAI +9,20, Gemini −9,58), ebenso im Kanal Saga-Wissen (OpenAI −7,90, Gemini +8,63).
6
Claude, beschreibend
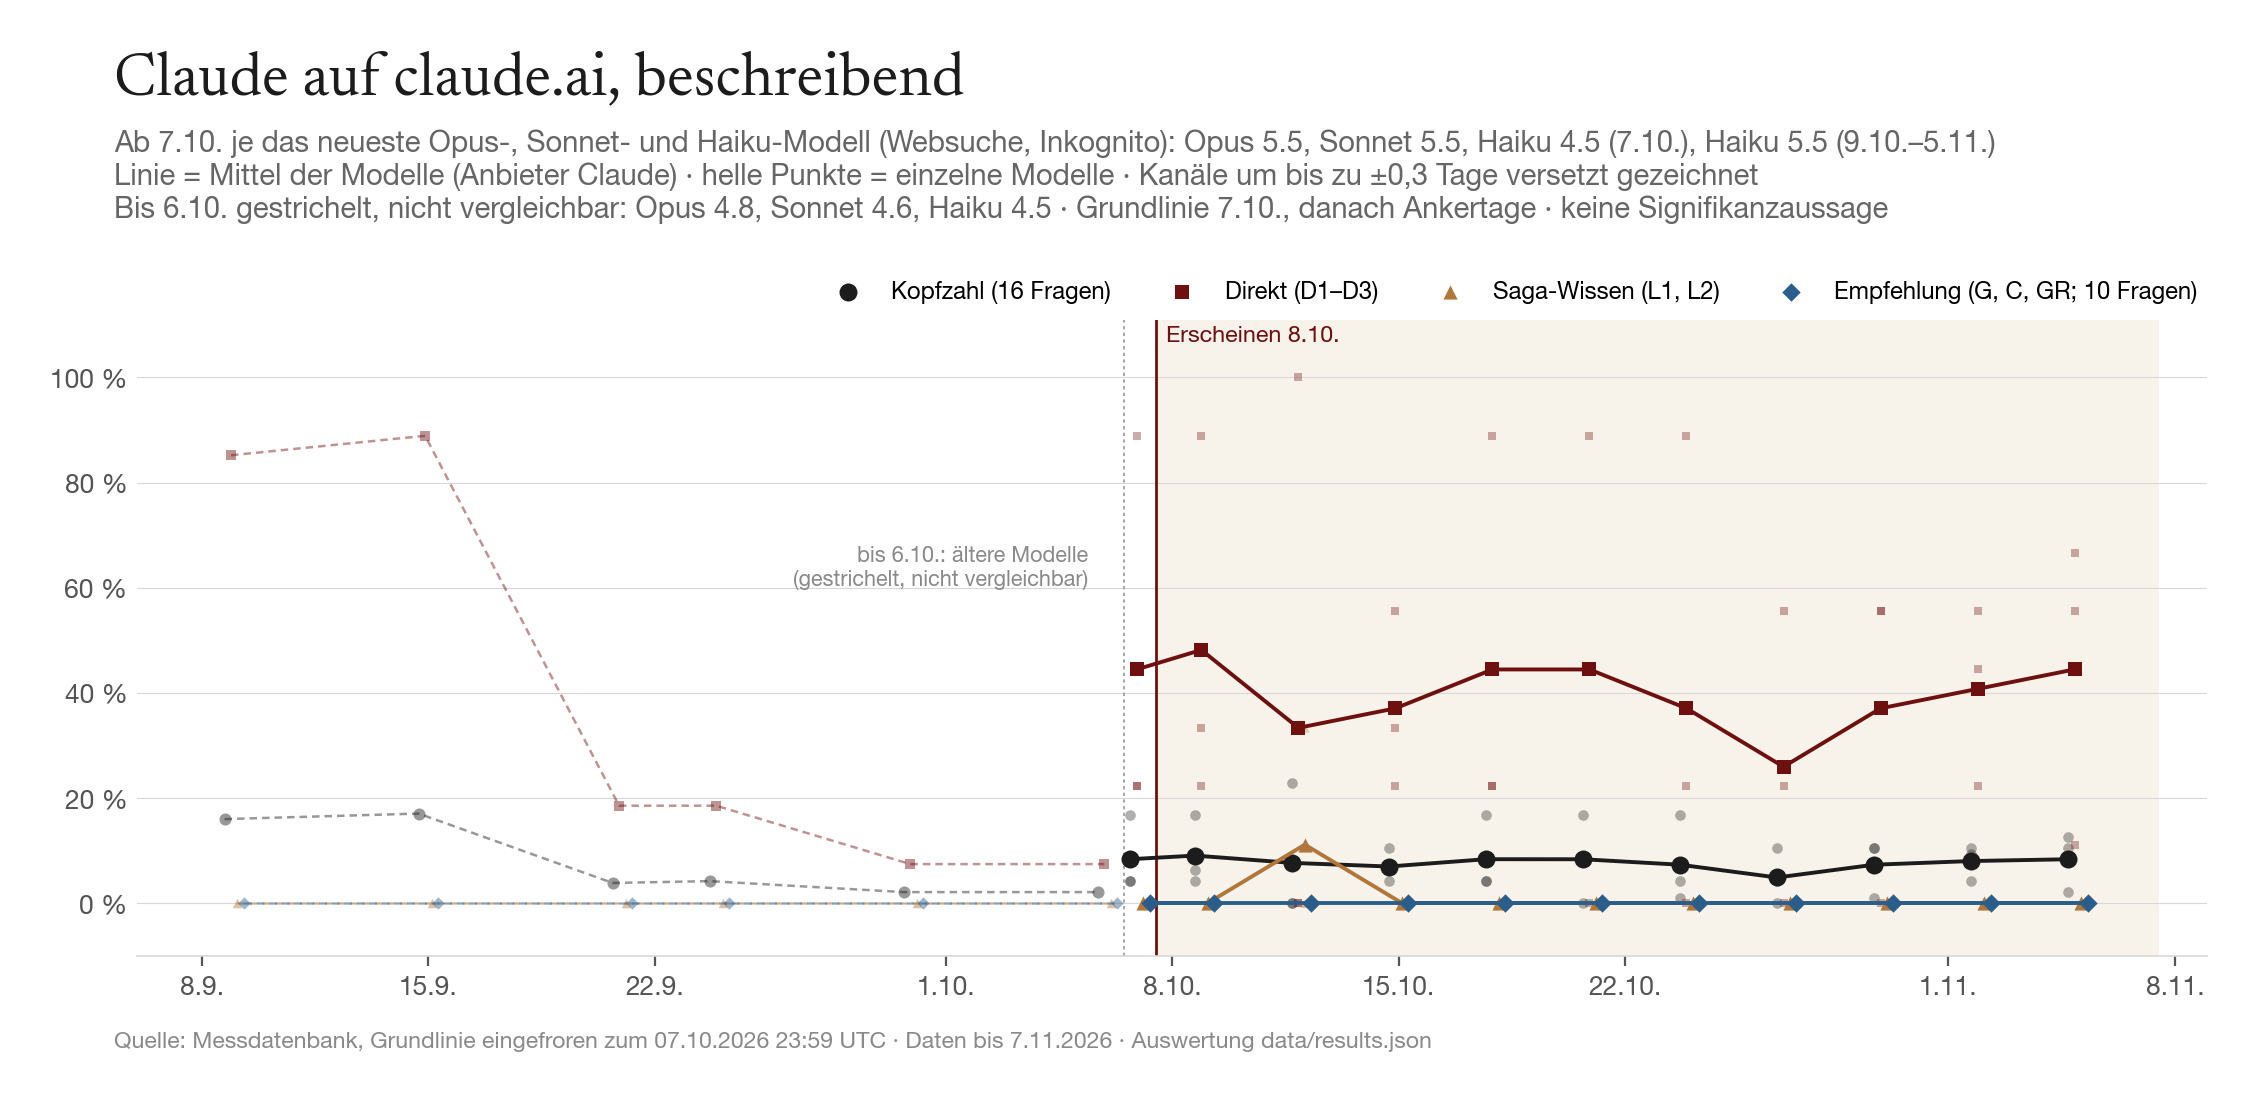
Gemessen wurde je das neueste Modell der drei Familien: in der Grundlinienmessung am 7. Oktober claude-haiku-4-5-20251001, claude-opus-5-5, claude-sonnet-5-5, ab dem 9. Oktober claude-haiku-5-5, claude-opus-5-5, claude-sonnet-5-5. Bei Haiku wechselte damit das Modell zwischen Grundlinie und erstem Ankertag (Einträge 45 und 49); Opus und Sonnet blieben gleich. An jedem Tag liegen 48 von 48 Antworten mit Messwert vor, das Register verzeichnet für Claude im Wirkungsfenster keinen Ausfall.
| Tag | Claude Kopfzahl | Direkt | Saga-Wissen | Empfehlung | Opus | Sonnet | Haiku |
|---|---|---|---|---|---|---|---|
| 07.10. (Grundlinie) | 8,34 | 44,44 | 0,00 | 0,00 | 16,67 | 4,17 | 4,17 |
| 09.10. | 9,03 | 48,15 | 0,00 | 0,00 | 16,67 | 4,17 | 6,25 |
| 12.10. | 7,64 | 33,33 | 11,11 | 0,00 | 22,92 | 0,00 | 0,00 |
| 15.10. | 6,95 | 37,04 | 0,00 | 0,00 | 10,42 | 4,17 | 6,25 |
| 18.10. | 8,34 | 44,44 | 0,00 | 0,00 | 16,67 | 4,17 | 4,17 |
| 21.10. | 8,33 | 44,44 | 0,00 | 0,00 | 16,67 | 8,33 | 0,00 |
| 24.10. | 7,29 | 37,04 | 0,00 | 0,00 | 16,67 | 4,17 | 1,04 |
| 27.10. | 4,86 | 25,93 | 0,00 | 0,00 | 10,42 | 4,17 | 0,00 |
| 30.10. | 7,29 | 37,04 | 0,00 | 0,00 | 10,42 | 10,42 | 1,04 |
| 02.11. | 7,99 | 40,74 | 0,00 | 0,00 | 10,42 | 4,17 | 9,38 |
| 05.11. | 8,33 | 44,45 | 0,00 | 0,00 | 12,50 | 10,42 | 2,08 |
In der Grundlinienmessung lag der Tageswert bei 8,34 Prozent (Opus 16,67, Sonnet 4,17, Haiku 4,17). An den Ankertagen reichte er von 4,86 bis 9,03, im Direkt-Kanal von 25,93 bis 48,15. Saga-Wissen lag nur am 12. Oktober (11,11) über null, Empfehlung an keinem Tag. Am letzten Ankertag, dem 5. November, beträgt die Differenz zur Grundlinienmessung im Mittel −0,01 Prozentpunkte (Direkt +0,01); je Modell Opus −4,17, Sonnet +6,25, Haiku −2,09. Auch die Claude-Werte folgen durchgehend dem Bewerter in der vorregistrierten Fassung; am 5. November ist dafür die Antwort von Sonnet auf die Frage D1 nach der Neubewertung am Volltext mit null Punkten gezählt. Sie beschreibt den Autor zutreffend und grenzt ihn am Ende gegen Pauline Kael ab; dasselbe gilt für die Antworten von Opus und Sonnet am 30. Oktober und am 2. November (Abschnitt 1). Nach dem Wortlaut von Eintrag 43 erhielte jede dieser Antworten einen Punkt. Der Tageswert im Mittel der drei Modelle läge dann am 30. Oktober bei 8,68 statt 7,29, am 2. November bei 9,38 statt 7,99 und am 5. November bei 9,03 statt 8,33 Prozent; Sonnet läge am 5. November bei 12,50 statt 10,42 Prozent. Für Claude gibt es keine Signifikanzaussage. Die Tageswerte von Claude liegen an allen Tagen unter denen von OpenAI und Gemini.
7
Robustheit und Sensitivität
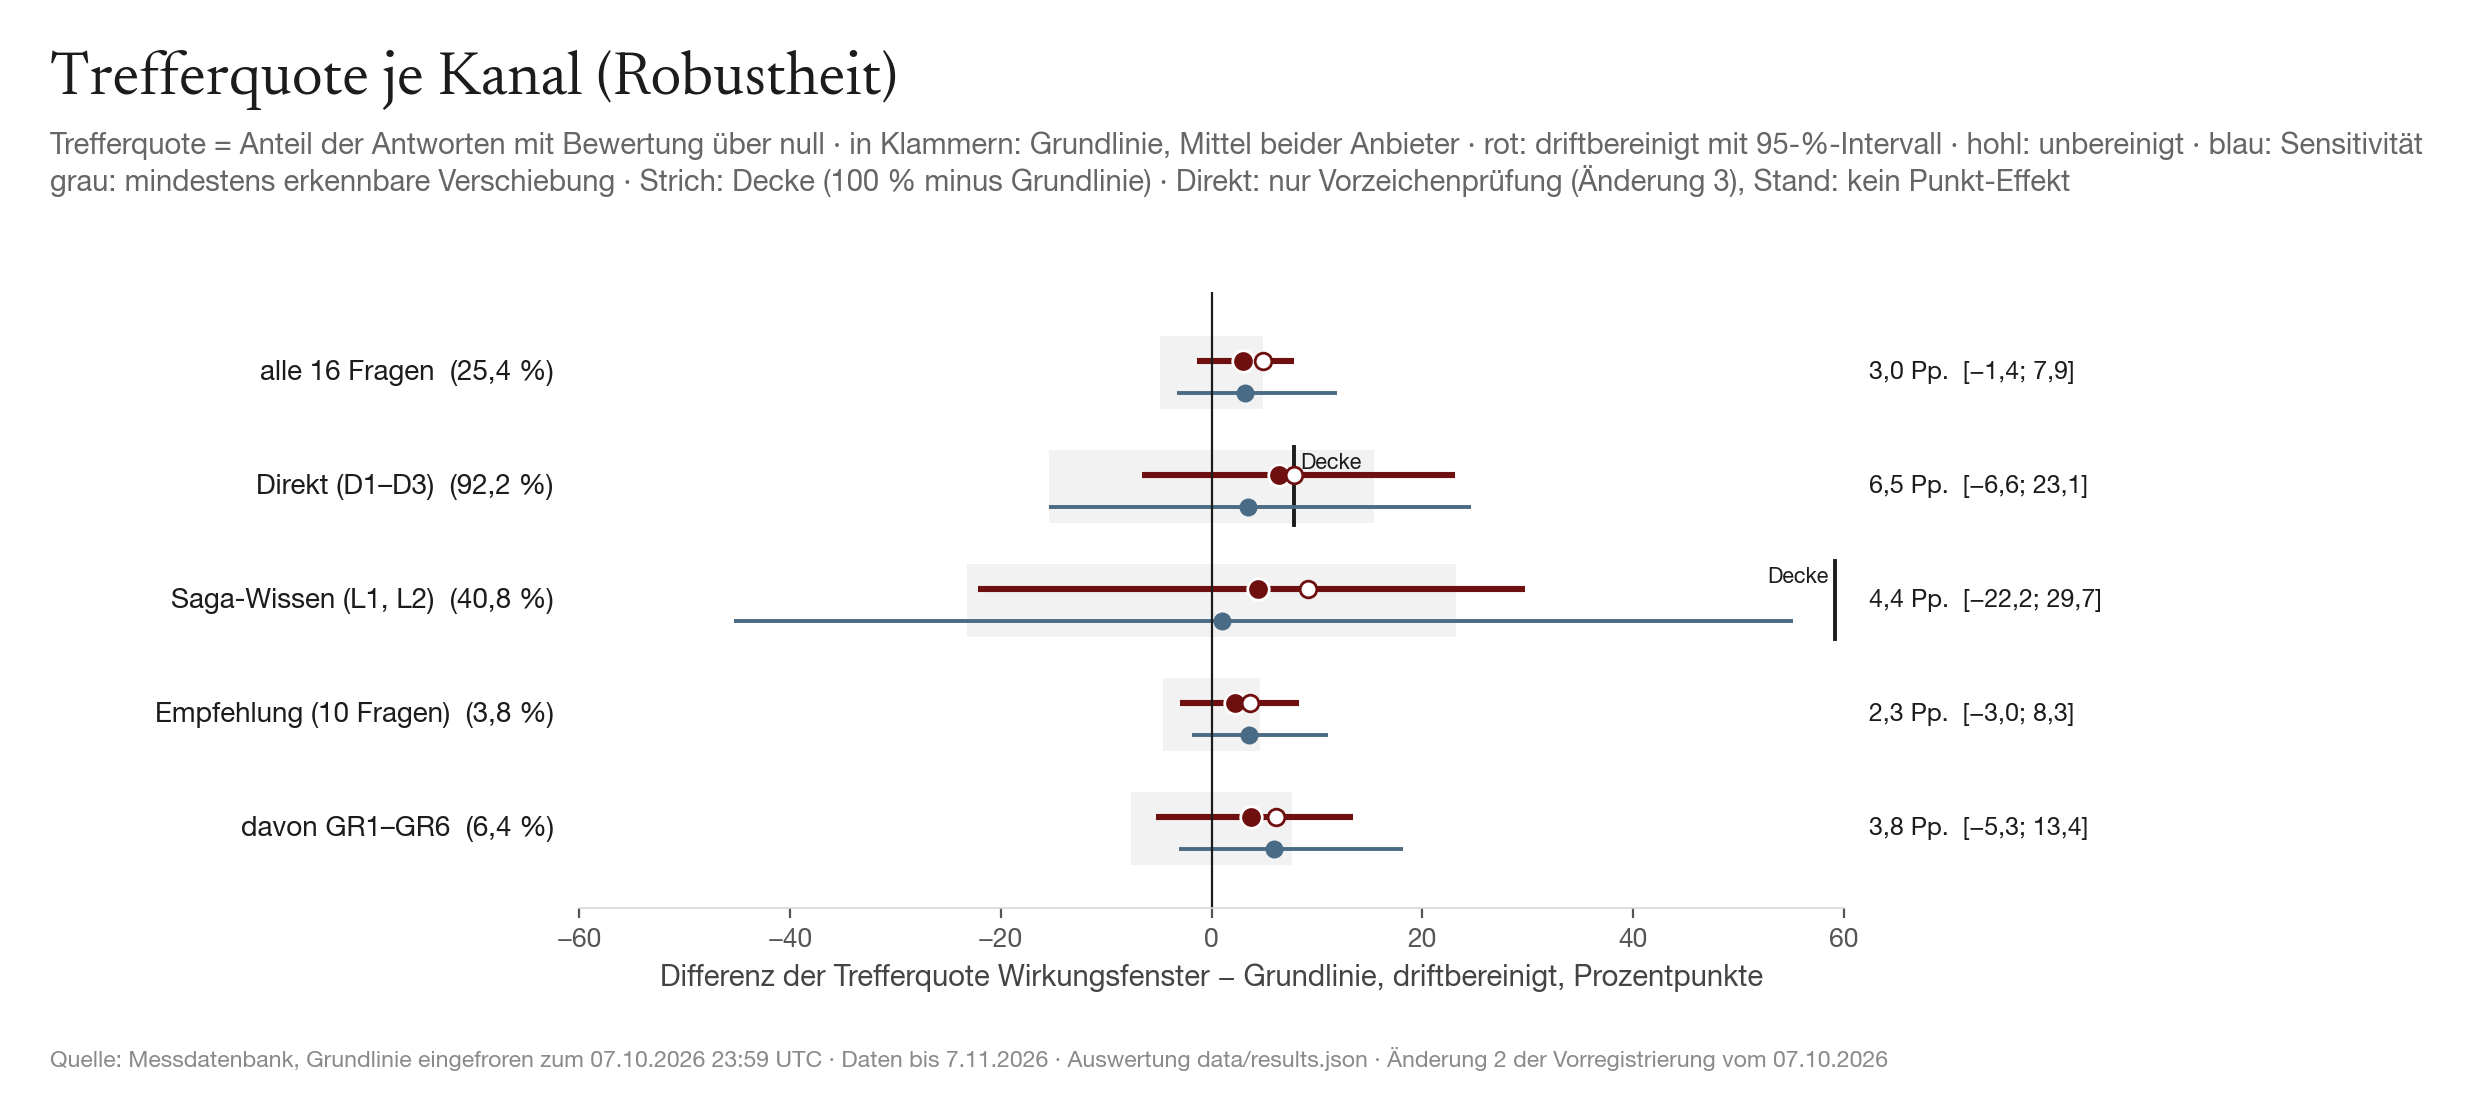
Trefferquote, driftbereinigte Differenz Wirkungsfenster minus Grundlinie im Mittel beider Anbieter (Prozentpunkte, 95-%-Intervall): alle Fragen +2,95 (−1,40 bis 7,85), Direkt +6,45 (−6,55 bis 23,09), Saga-Wissen +4,42 (−22,16 bis 29,72), Empfehlung +2,27 (−2,97 bis 8,29), GR1 bis GR6 +3,79 (−5,26 bis 13,42). Alle Intervalle enthalten die Null. Der CUSUM der Trefferquote über alle Fragen alarmiert wie die Kopfzahl am 5. November aufwärts, an einem Tag mit nur OpenAI; die Kanäle alarmieren nicht, ihre höchste CUSUM-Summe liegt zwischen 0,70 und 3,68 bei der Schwelle 5. Nach der Intervall-Regel ist in keinem Kanal ein Effekt robust, weil schon die Intervalle der Punkt-Differenzen die Null enthalten. Im Direkt-Kanal gibt es nach Änderung 3 keinen zu prüfenden Punkt-Effekt; der Schätzwert der Trefferquote (+6,45) wird deshalb nicht als Bestätigung gelesen.
Gegen die Sensitivitäts-Grundlinie vom 8. bis 29. September (OpenAI 3, Gemini 7 Ankertage) betragen die driftbereinigten Differenzen: Kopfzahl +0,74 (−5,08 bis 8,22), Direkt −6,27 (−29,18 bis 14,27), Saga-Wissen −3,54 (−37,24 bis 38,88), Empfehlung +3,55 (−1,96 bis 11,06), GR1 bis GR6 +5,92 (−3,06 bis 18,90). Auch hier schließt kein Intervall im Mittel beider Anbieter die Null aus. Für einzelne Anbieter schließen driftbereinigt nur diese Intervalle die Null aus, alle gegen die Sensitivitäts-Grundlinie: OpenAI, Empfehlung in Punkten +5,00 (0,86 bis 15,36); OpenAI, GR1 bis GR6 in Punkten +8,33 (1,52 bis 27,02); Gemini, Trefferquote alle Fragen +7,36 (0,89 bis 16,80); Gemini, Trefferquote Saga-Wissen +30,99 (0,98 bis 55,49); OpenAI, Trefferquote Empfehlung +5,00 (0,81 bis 15,91); OpenAI, Trefferquote GR1 bis GR6 +8,33 (1,50 bis 25,94). Die Entscheidung der Vorregistrierung stützt sich auf das Mittel beider Anbieter. Ohne Driftabzug schließen in der Hauptanalyse die Intervalle für Kopfzahl +3,38 (0,05 bis 6,93) und Trefferquote alle Fragen +4,89 (2,08 bis 7,71) die Null aus, gegen die Sensitivitäts-Grundlinie die für Kopfzahl +4,23 (0,97 bis 7,77), Empfehlung +4,64 (0,93 bis 8,36), GR1 bis GR6 +7,73 (1,67 bis 13,93), Trefferquote alle Fragen +6,05 (3,05 bis 8,93), Trefferquote Empfehlung +4,64 (1,00 bis 8,36) und Trefferquote GR1 bis GR6 +7,73 (1,55 bis 13,93); bei der Kopfzahl der Hauptanalyse hängt das vom Startwert ab (Abschnitt 4). Maßgeblich ist nach der Vorregistrierung die driftbereinigte Differenz; die Driftbereinigung verkleinert jeden dieser Werte. Mit den Bewertungsregeln vom 2. November in Grundlinie und Wirkungsfenster (Eintrag 71) ergeben sich Kopfzahl +2,77 (−2,37 bis 8,28), Direkt +4,22 (−10,31 bis 19,31) und Saga-Wissen +4,75 (−18,83 bis 27,93); die Grundlinie der Kopfzahl liegt dann bei 21,59 statt 22,45 Prozent. In Driftbasis und Grundlinie sind die neuen Regeln dabei nur am gespeicherten Auszug von 500 Zeichen angewendet. Das ändert 41 gespeicherte Antworten: 18 von OpenAI und Gemini, 22 aus der älteren Claude-Reihe und eine aus der Claude-Grundlinienmessung vom 7. Oktober. In die Kennzahlen von OpenAI und Gemini gehen davon 9 ein, die auf Ankertagen liegen (Gemini 8, OpenAI 1); die übrigen 9 liegen auf Zwischentagen, die nicht ausgewertet werden (Abschnitt 2). Vor dem 15. September bleibt der damals gültige Termin 22. September gewertet. Mit diesen Regeln alarmiert der CUSUM der Kopfzahl schon am 30. Oktober. Die Entscheidung bleibt gleich. Der Abgleich des Grundlinienbestands mit dem Abzug vom 8. November ergibt keine fehlenden, geänderten oder neuen Zeilen (Abschnitt 2).
Leere Antworten. Vor dem 1. November gehen sie als Antwort ohne Fund mit null Punkten ein (Eintrag 66). Auf den Ankertagen sind das 19 Antworten, alle von Gemini: 7 in der Driftbasis, 7 in der Grundlinie und 5 im Wirkungsfenster; bei OpenAI gab es auf Ankertagen keine leere Antwort. Als Lücke gewertet fehlt die Frage an diesem Tag, und der Tageswert wird aus den übrigen Fragen gebildet. Dann beträgt die Differenz der Kopfzahl +1,70 (−3,27 bis 6,96), unbereinigt +3,77 (0,51 bis 7,13); Direkt −0,19 (−15,51 bis 15,53), Saga-Wissen +0,37 (−20,94 bis 22,34), Empfehlung +2,42 (−3,01 bis 8,38), GR1 bis GR6 +4,62 (−4,74 bis 14,43). Weder die Kopfzahl noch ein Kanal oder eine Trefferquote alarmiert, der Alarm der Hauptanalyse am 5. November entfällt also, und die Entscheidung bleibt gleich. Als Fehlmessung gewertet ist der Anbieter-Tag unvollständig und entfällt. Gemini bleiben dann 2 Ankertage in der Driftbasis, 5 in der Grundlinie und einer im Wirkungsfenster (21. Oktober); für Gemini lässt sich kein Intervall berechnen, und der Schätzwert der Kopfzahl im Mittel beider Anbieter (+11,23) ist nicht deutbar. In dieser Variante alarmiert der CUSUM der Kopfzahl und der Trefferquote über alle Fragen am 30. Oktober, der des Empfehlungs-Kanals und der Fragen GR1 bis GR6 am 5. November; der Direkt-Kanal alarmiert nicht. Der Empfehlungs-Kanal reagiert damit vor dem Direkt-Kanal, und die Reihenfolge-Hypothese erhält auch hier keine Stütze. Wegen der wenigen verbleibenden Gemini-Tage ist diese Variante nicht aussagekräftig.
Ohne Änderung 4. Werden die beiden am 15. Oktober rückwirkend geänderten Antworten vom 12. Oktober wieder mit null Punkten gezählt, beträgt die Differenz der Kopfzahl +0,96 (−4,15 bis 6,36), unbereinigt +2,97 (−0,62 bis 6,72), und im Kanal Saga-Wissen −2,97 (−25,11 bis 19,75); Direkt, Empfehlung und GR1 bis GR6 bleiben gleich. Das unbereinigte Intervall der Kopfzahl schließt die Null in der Hauptanalyse also nur wegen dieser einen Gemini-Antwort aus, und auch dann nicht bei jedem Startwert (Abschnitt 4). Der CUSUM-Alarm der Kopfzahl am 5. November bleibt, und die Entscheidung ändert sich nicht. Durchgesehen wurden die Volltexte aller 57 Antworten von OpenAI und Gemini, die an den Ankertagen vom 18. Oktober bis 8. November nach den vorregistrierten Regeln Punkte über null haben. 54 nennen den Autor namentlich, 2 Direkt-Antworten zur Frage D3 nennen ihn über die Domain, und eine Antwort von OpenAI zur Frage R1 vom 8. November erhält einen halben Punkt, weil sie das Wort Marin aus der Frage wiederholt; nach den Werten der Messdatenbank hat sie null Punkte, dort sind es 56 Antworten. Keine weitere Antwort hängt damit allein am Titel als Anker; für D2 und D3 gilt der Titel-Anker ohnehin nicht. Für Claude wurde das nicht geprüft.
Zusatzangaben, nicht vorregistriert. Beschränkt auf die 5 Ankertage mit beiden Anbietern (9. Oktober bis 21. Oktober) liegt die Kopfzahl driftbereinigt bei −0,26 (−4,96 bis 4,82), unbereinigt bei +1,82 (−1,68 bis 5,52); der positive Schätzwert der Hauptanalyse stammt damit aus den späteren Tagen, an denen nur OpenAI misst. Gegen die eigene Driftgerade liegt OpenAI in der ersten Hälfte des Wirkungsfensters (9. Oktober bis 21. Oktober) im Mittel bei −1,04, in der zweiten (24. Oktober bis 5. November) bei +5,49 Prozentpunkten. Der CUSUM-Alarm der Kopfzahl am 5. November ist knapp: Die höchste Summe beträgt 5,25 bei der Schwelle 5. Er tritt nur auf, solange die Standardabweichung, mit der standardisiert wird, unter 3,941 liegt; verwendet wurde die nach dem vorab festgelegten Verfahren aus der Grundlinie berechnete 3,821. Mit den Bewertungsregeln vom 2. November alarmiert die Kopfzahl schon am 30. Oktober. Die Entscheidung über die Nullhypothese hängt nicht an diesem Alarm.
Die Beobachtung verzögerter Wirkung umfasst 20 Ankertage vom 8. November bis 4. Januar 2027. In der Hauptanalyse ist keiner davon ausgewertet; den ersten, den 8. November, zählt nur die nicht vorregistrierte Erweiterung im folgenden Unterabschnitt zum Wirkungsfenster. Die Beobachtung wird nach dem 6. Januar 2027 eingefroren und als Nachtrag beschreibend berichtet; eine neue Signifikanzaussage folgt daraus nicht.
7.1 Erweiterung bis zum Ankertag 8. November (nicht vorregistriert)
Nach dem Ende des Wirkungsfensters habe ich entschieden, zusätzlich zur vorregistrierten Hauptanalyse eine Erweiterung des Wirkungsfensters bis einschließlich des Ankertages 8. November zu berichten (Eintrag 83). Anlass ist die Gemini-Messung dieses Tages: Gemini fehlte an den letzten fünf Ankertagen des Wirkungsfensters, am 8. November ist es wieder gemessen. Die Erweiterung ist nicht vorregistriert. Hypothese, Nullhypothese, Kennzahlen, Driftbereinigung, Bewertungsregeln und Entscheidungsregel bleiben unverändert, und über die Hypothesen entscheidet allein die Hauptanalyse mit dem Wirkungsfenster bis 7. November. Nach der Vorregistrierung gehört der 8. November zur Beobachtung verzögerter Wirkung. Am Morgen des 8. November lehnten beide Schnittstellen alle Fragen ab (Einträge 80 und 81). Nachgemessen wurden OpenAI um 14:24 UTC nach der Nachhol-Regel aus Eintrag 44 und Gemini um 15:48 UTC nach der Nachhol-Regel aus Eintrag 82, die am selben Tag um 14:30 UTC vor ihrer ersten Anwendung erfasst wurde. Die Erweiterung selbst ist im Register um 15:52 UTC erfasst, nach beiden Nachmessungen; sie ist deshalb als nachträgliche Auswertung zu lesen. Die Gemini-Lücken vom 24. Oktober bis 5. November werden nicht nachgemessen. Grundlage ist der dritte Abzug vom 8. November (Abschnitt 2). Die 80 Antworten des 8. November sind am Volltext nach den vorregistrierten Regeln bewertet; drei davon weichen vom Wert der Messdatenbank ab, keine von Gemini, und zusammen mit den elf der Hauptanalyse setzt die Erweiterung 14 Antworten zurück. Gerechnet wird mit demselben Verfahren und demselben Startwert wie in der Hauptanalyse.
| Kanal | Hauptanalyse | Erweiterung | 95-%-Intervall | unbereinigt | 95-%-Intervall unbereinigt | erster Alarm |
|---|---|---|---|---|---|---|
| Kopfzahl | +1,38 | +2,32 | [−2,74; 7,95] | +4,72 | [1,03; 8,60] | 05.11. |
| Direkt | −0,19 | +1,13 | [−14,70; 17,46] | +3,94 | [−4,63; 13,52] | keiner |
| Saga-Wissen | +0,37 | +4,39 | [−18,50; 29,14] | +10,49 | [−5,20; 26,72] | keiner |
| Empfehlung | +2,27 | +2,31 | [−3,03; 8,28] | +3,90 | [0,44; 7,38] | keiner |
| davon GR1–GR6 | +3,79 | +3,85 | [−5,35; 13,64] | +6,49 | [0,53; 12,25] | keiner |
| Trefferquote alle Fragen | +2,95 | +3,92 | [−0,88; 9,31] | +6,25 | [3,01; 9,54] | 05.11. |
Am 8. November lag OpenAI bei 30,21 und Gemini bei 39,58 Prozent, die Kopfzahl bei 34,89 Prozent. Mit diesem Tag gehen für OpenAI 11 und für Gemini 6 Wirkungs-Ankertage ein, die Kopfzahl ist an 6 Ankertagen definiert. Driftbereinigt beträgt die Differenz der Kopfzahl bei OpenAI +2,67 (−4,43 bis 9,28), bei Gemini +1,97 (−5,46 bis 10,96) und im Mittel +2,32 Prozentpunkte (−2,74 bis 7,95); unbereinigt sind es im Mittel +4,72 (1,03 bis 8,60), und die an den gemessenen Wirkungstagen fortgeschriebene Drift beträgt 2,40. Das Intervall der bereinigten Differenz enthält die Null. In den Kanälen und in der Trefferquote enthält jedes driftbereinigte Intervall im Mittel beider Anbieter die Null (Tabelle 6), auch gegen die Sensitivitäts-Grundlinie; dort beträgt die Differenz der Kopfzahl +1,73 (−4,30 bis 9,69). Für einzelne Anbieter schließen driftbereinigt nur diese Intervalle die Null aus, alle gegen die Sensitivitäts-Grundlinie: OpenAI, Empfehlung in Punkten +5,45 (1,40 bis 16,96); OpenAI, GR1 bis GR6 in Punkten +9,09 (2,28 bis 27,85); Gemini, Trefferquote alle Fragen +8,69 (1,64 bis 19,78); Gemini, Trefferquote Saga-Wissen +37,56 (4,06 bis 75,00); OpenAI, Trefferquote Empfehlung +5,45 (1,42 bis 16,08); OpenAI, Trefferquote GR1 bis GR6 +9,09 (2,24 bis 27,95). Ohne Driftabzug schließen gegen die Grundlinie die Intervalle für Kopfzahl +4,72 (1,03 bis 8,60), Empfehlung +3,90 (0,44 bis 7,38), GR1 bis GR6 +6,49 (0,53 bis 12,25), Trefferquote alle Fragen +6,25 (3,01 bis 9,54), Trefferquote Empfehlung +3,90 (0,44 bis 7,30) und Trefferquote GR1 bis GR6 +6,49 (0,66 bis 12,17) die Null aus, gegen die Sensitivitäts-Grundlinie die für Kopfzahl +5,57 (1,91 bis 9,39), Empfehlung +4,87 (1,54 bis 8,16), GR1 bis GR6 +8,12 (2,63 bis 13,73), Trefferquote alle Fragen +7,42 (4,19 bis 10,89), Trefferquote Empfehlung +4,87 (1,51 bis 8,16) und Trefferquote GR1 bis GR6 +8,12 (2,63 bis 13,60). Maßgeblich ist wie in der Hauptanalyse die driftbereinigte Differenz im Mittel beider Anbieter; die Driftbereinigung verkleinert jeden dieser Werte. Der CUSUM alarmiert wie in der Hauptanalyse nur für die Kopfzahl und die Trefferquote über alle Fragen, beide am 5. November. Direkt und Empfehlung alarmieren nicht, auch nicht mit GR1 bis GR6, und die Reihenfolge-Hypothese erhält keine Stütze. Nach der Intervall-Regel ist in keinem Kanal ein Effekt robust, und im Direkt-Kanal gibt es keinen zu prüfenden Punkt-Effekt.
Gegenüber der Hauptanalyse steigt der Schätzwert der Kopfzahl um 0,94 Prozentpunkte. Das Intervall enthält weiterhin die Null, und die Entscheidung über die Nullhypothese wäre dieselbe. Für Gemini kommt ein einzelner Tag am Ende des Fensters hinzu; die Lücke vom 24. Oktober bis 5. November bleibt, und die Gemini-Differenz beruht weiterhin auf fünf Tagen der ersten Fensterhälfte und diesem einen Tag. Claude lag am 8. November im Mittel der drei Modelle bei 5,90 Prozent (Direkt 29,63); dieser Wert ist beschreibend.
8
Abweichungen vom Plan
Tabelle 7 fasst zusammen, wo dieser Bericht vom ursprünglichen Plan abweicht, wann die Abweichung festgelegt wurde, wo sie im Lückenregister steht und wie sie behandelt ist. Die Änderungen 1 bis 3 und die Festlegungen vom 7. Oktober wurden vor dem Ereignis registriert, mit Ausnahme des Empfehlungs-Kanals aus zehn Fragen, der am 7. Oktober vor dem Ereignis nur im Auswertungscode festgelegt wurde; alle späteren sind als solche gekennzeichnet und, wo sie Werte berühren, durch eine Sensitivitätsrechnung begleitet.
| Abweichung | festgelegt | Eintrag | Behandlung |
|---|---|---|---|
| Änderungen 1 bis 3: Panel OpenAI und Gemini, Claude beschreibend, Sensitivitäts-Grundlinie, Trefferquote, Einzelheiten der Auswertung, Direkt-Regel | 07.10., vor dem Ereignis | 36, 38, 39 | Teil der Vorregistrierung (Abschnitte 1 und 3) |
| Festlegungen: Claude mit drei Modellfamilien, ehrlicher Nichtfund | 07.10., vor dem Ereignis | 41, 42 | in Grundlinie und Wirkungsfenster gleich angewendet (Abschnitte 1 und 2) |
| Namens-Kollision mit Pauline Kael; der Bewerter in der vorregistrierten Fassung setzt den Teil zu echten Angaben über den Autor enger um als der Wortlaut | 07.10., vor dem Ereignis; als Fehler erkannt am 02.11. | 43, 71 | vor dem Ereignis eine Gemini-Antwort nach dem Wortlaut nachbewertet; im Wirkungsfenster folgt die Hauptanalyse dem Bewerter: 5 Claude-Antworten (in der Erweiterung 6) mit null Punkten, OpenAI und Gemini nicht betroffen; Claude-Werte nach dem Wortlaut beschreibend (Abschnitte 1 und 6) |
| Nachhol-Regel für OpenAI | 07.10., vor dem Ereignis | 44 | nur im Wirkungsfenster wirksam (02.11.; in der Erweiterung auch 08.11.), die Grundlinie enthält keine Nachmessung (Abschnitt 2) |
| Empfehlungs-Kanal mit zehn Fragen statt GR1 bis GR6 | 07.10., im Auswertungscode, nicht registriert | – | GR1 bis GR6 überall mitberichtet, gleiches Urteil (Abschnitte 2 und 5) |
| Änderung 4: Buch- oder Reihentitel als Anker | 15.10., im Wirkungsfenster | 50 | Sensitivität ohne Änderung 4 (Abschnitt 7) |
| Leere Antworten als Fehlmessung, Wiederholung im selben Lauf | 01.11. und 02.11., im Wirkungsfenster | 66, 70 | vorher null Punkte; Sensitivität als Lücke und als Fehlmessung (Abschnitt 7) |
| Bewertungsregeln vom 2. November | 02.11., im Wirkungsfenster | 71 | Hauptanalyse mit den vorregistrierten Regeln, 11 Antworten zurückgesetzt; Sensitivität (Abschnitt 7) |
| Gemini fehlt an 5 Wirkungs-Ankertagen | 24.10. bis 05.11. | 58, 61, 64, 67, 74 | nicht nachgemessen; Zusatzangabe mit den Tagen beider Anbieter (Abschnitt 7) |
| Nachhol-Regel für Gemini | 08.11., nach dem Wirkungsfenster | 82 | nur in der Erweiterung wirksam (Abschnitt 7) |
| Erweiterung bis zum Ankertag 8. November | 08.11., nach dem Wirkungsfenster | 83 | eigener Unterabschnitt, nicht vorregistriert, ohne Einfluss auf die Entscheidung (Abschnitt 7) |
| Erfassungsdaten der Einträge 12 und 18 | Vermerk vom 08.11. | 12, 18 | Daten nach dem Register (Abschnitt 1) |
9
Grenzen
Die Studie hat auf der Ebene des Autors n gleich eins und keine Vergleichsgruppe; jede Veränderung im Wirkungsfenster ist mit allem vereinbar, was im selben Zeitraum geschieht, auch mit Änderungen der Suchsysteme der Anbieter. Die Grundlinie ist kurz: OpenAI hat nach dem Ausfall im September sechs Grundlinientage, in der Sensitivitäts-Grundlinie drei. Die mindestens erkennbare Verschiebung liegt als Planungswert bei zehn Wirkungstagen je Anbieter für die Kopfzahl bei 4,68 Prozentpunkten, im Direkt-Kanal bei 14,84 und im Kanal Saga-Wissen bei 20,12; mit der Unsicherheit der Drift und den tatsächlich gemessenen Wirkungstagen liegt sie bei 7,32, 21,93 und 31,12. Kleinere Wirkungen erkennt das Design mit weniger als 80 Prozent Power. Mit den Daten vereinbar sind bei der Kopfzahl Wirkungen bis +6,68 Prozentpunkte, das sind 29,8 Prozent der Grundlinie. Der Validierungsbericht Q3/2026 fand Verschiebungen des Intervallmittels um 1,58 bis 4,01 Prozentpunkte ohne dokumentierte Ursache (DOI 10.5281/zenodo.23145378); Effekte dieser Größe sind von Instrumentdrift nicht zu trennen. Die Trefferquote im Direkt-Kanal liegt in der Grundlinie im Mittel beider Anbieter bei 92,2 Prozent; ein Anstieg kann höchstens 7,8 Prozentpunkte betragen und liegt damit unter der mindestens erkennbaren Verschiebung. Deshalb dient die Trefferquote im Direkt-Kanal nach Änderung 3 nur der Vorzeichenprüfung; ein Anstieg im Direkt-Kanal stützt sich damit allein auf die Punkte und bleibt der Verzerrung durch die teilweise Nachbewertung ausgesetzt. Die lineare Fortschreibung der Drift über 30 Tage ist eine Annahme. Die Nachbewertung zum Erscheinungstermin (Eintrag 37) erfasste in der Grundlinie nur Antworten, deren Auszug von 500 Zeichen die Kernfakten belegt; weitere Grundlinien-Antworten mit dem neuen Termin stehen vermutlich noch bei zwei statt drei Punkten, während Antworten im Wirkungsfenster vollständig nach der neuen Regel bewertet werden. Das kann die Differenz im Direkt-Kanal und in der Kopfzahl nach oben verzerren; die Größe ist ohne Volltexte nicht bestimmbar. Die Trefferquote ist von dieser Schwelle unabhängig. Die Vorab-Verfügbarkeit ab dem 30. September liegt in der Grundlinie; die Sensitivitäts-Grundlinie fängt das nur mit weniger Tagen auf. Der Empfehlungs-Kanal stand in der Grundlinie nahe null und kann deshalb vor allem ein erstes Auftreten anzeigen. Die Einzelheiten der Auswertung und die Trefferquote wurden erst am 7. Oktober festgelegt, vor dem Ereignis, aber in Kenntnis der Grundlinie. Für Claude gibt es nur eine Grundlinienmessung. Im Wirkungsfenster fehlt Gemini an 5 von 10 Ankertagen; die Gemini-Differenz beruht auf der ersten Hälfte des Fensters, und eine spät einsetzende Wirkung kann bei Gemini nicht sichtbar werden. Beschränkt auf die Tage mit beiden Anbietern ist der Schätzwert der Kopfzahl negativ (Abschnitt 7). Der CUSUM-Alarm der Kopfzahl am 5. November fällt in die Tage mit nur einem Anbieter und ist von diesem Basiswechsel nicht zu trennen; er ist zudem knapp und hängt an der Streuung der Grundlinie (Abschnitt 7). Änderung 4 wurde im laufenden Wirkungsfenster festgelegt; sie wirkt auf Grundlinie und Wirkungsfenster nach derselben Regel, ändert aber eine Gemini-Antwort im Wirkungsfenster, und ohne sie enthält auch das unbereinigte Intervall der Kopfzahl die Null. Die Bewertungsregeln vom 2. November sind in der Hauptanalyse zurückgesetzt, der 5. November ist dafür am Volltext nach den vorregistrierten Regeln neu bewertet; in der Sensitivität sind die neuen Regeln in Driftbasis und Grundlinie nur am Auszug von 500 Zeichen angewendet (41 geänderte Antworten, davon 9 von OpenAI und Gemini auf Ankertagen). Den Teil von Eintrag 43 zu echten Angaben über den Autor setzt der Bewerter in der vorregistrierten Fassung enger um als dessen Wortlaut; das betrifft nur beschreibende Claude-Werte (Abschnitte 1 und 6). Leere Antworten vor dem 1. November gehen mit null Punkten ein, auf Ankertagen 19, alle bei Gemini; als Lücke gewertet bleibt die Entscheidung gleich, als Fehlmessung gewertet bleibt für Gemini ein einziger Wirkungstag, und die Variante ist wegen der wenigen Gemini-Tage nicht aussagekräftig. Der Empfehlungs-Kanal der Entscheidung umfasst zehn Fragen statt der vorregistrierten sechs; beide Fassungen führen zum selben Urteil. Die Erweiterung bis zum 8. November ist nicht vorregistriert, nach dem Ende des Wirkungsfensters und nach den Messungen dieses Tages erfasst und fügt für Gemini nur einen Tag hinzu. Bei Claude wechselte das Haiku-Modell zwischen Grundlinie und erstem Ankertag, und die Websuche ist nicht erzwungen; vor dem 2. November ist nicht bekannt, bei wie vielen Antworten gesucht wurde.
10
Reproduzierbarkeit
Die Vorregistrierung Q7 liegt im öffentlichen Repositorium github.com/marintkael/marin-research-tools im Ordner pre_registrations (Fassung 1.4 vom 15. Oktober 2026, mit datierten Vermerken vom 8. November 2026); die Einträge 12, 18, 36, 38, 39 und 50 des Lückenregisters dokumentieren Anlage, Neudatierung und die vier Änderungen, die Einträge 66, 71 und 83 die Nachträge zu leeren Antworten, zu den Bewertungsregeln und zur Erweiterung. Auswertungscode, die beiden eingefrorenen Abzüge der Hauptanalyse und der Abzug der Erweiterung mit Stichtag, Zeilenzahlen und Prüfsummen sowie der Figurenbau erscheinen mit diesem Bericht im Repositorium. Alle Zahlen des Berichts außer denen der zusätzlichen Prüfung weiterer Startwerte (Abschnitt 4) stammen aus einem Auswertungslauf, der die Hauptanalyse in eine Datei und jede Sensitivitätsrechnung und die Erweiterung in eine eigene, dort benannte Datei schreibt; der Bootstrap verwendet einen festen Startwert. Die Prüfung weiterer Startwerte ist ein eigener Lauf mit eigener Datei.
11
Zitierhinweis
Kael, M. T. (2026). Bericht 04 · Buchstart und KI-Zitation: Vorher-Nachher-Auswertung der Vorregistrierung Q7. Marin T. Kael Research Programme. doi:10.5281/zenodo.24063460