Validierungsbericht · Q3 / 2026 · Datenstand 1. Oktober 2026
Validierungsbericht Q3 / 2026
Wie verlässlich misst das Programm? Prüfung der sechs Instrument-Hypothesen aus der Vorregistrierung Q0-INST
Zusammenfassung
Dieser Bericht prüft die sechs Instrument-Hypothesen der Vorregistrierung Q0-INST vom 11. Mai 2026 gegen den eingefrorenen Datenstand vom 1. Oktober 2026. Keine ist bestätigt. Drei sind nicht prüfbar, weil die vorgesehenen Erhebungen nicht stattgefunden haben; drei sind nicht bestätigt.
Dieselbe Frage erhält am folgenden Messtag bei OpenAI Search in 86,6 Prozent der Paare dieselbe Bewertung, bei Gemini in 87,1 und bei Claude (claude.ai mit Websuche) in 94,3 Prozent. Ohne die Fragen, deren Bewertung sich nie ändert, sind es 78,6, 70,6 und 85,0 Prozent. Die Korrelation zweier Einzelmessungen im Abstand eines Tages beträgt 0,746, 0,612 und 0,811. Das Fragenset bildet keine einheitliche Skala: Cronbachs α liegt zwischen 0,407 (Gemini, 95-Prozent-Intervall 0,279 bis 0,5) und 0,61 (Claude, 0,562 bis 0,651), und je nach Anbieter haben 6 bis 10 der 16 Fragen keine Varianz.
Gegen die Mai-Referenz meldet die CUSUM-Karte nur Aufwärts-Alarme (19, 30 und 44). Mit Neubezug der Referenz entstehen fünf Abwärts-Alarme (OpenAI 27. August und 30. September, Gemini 14. August, Claude 17. August und 19. September); keiner ist durch ein dokumentiertes Ereignis erklärt.
Die in Q0-INST als Anker benannten Wikidata-Items wurden im Fenster gelöscht. Der Google Knowledge Graph findet den Autor an 140 von 141 Tagen, das Buch an keinem von 139. Vollständig gemessen sind bei Gemini 102 von 113 Soll-Tagen, bei OpenAI 53 von 113, bei Claude 55 von 106; bei Claude fehlen 17 Tage ohne Registereintrag. Drei Teilstudien (Q0-KG, Q3, Q4) haben ihr vorregistriertes Erhebungsende überschritten und stehen weiterhin auf „aktiv“.
1
Fragestellung und Vorregistrierung
Das Programm untersucht, wann und wie KI-Antwortmaschinen einen neuen Autor finden und zitieren. Die erste Phase prüft die Messinstrumente; Wirkungsaussagen folgen in der zweiten Phase ab dem Erscheinen des ersten Bandes am 8. Oktober 2026.
Die Vorregistrierung Q0-INST (DOI 10.5281/zenodo.20125967, Fassung 1.0; bis Oktober 2026 als „Q0“ geführt) legt ein Beobachtungsfenster vom 11. Mai bis 22. September 2026 und sechs Hypothesen fest: Wiederhol-Reliabilität der API-Flächen (INST-01), Gewinn durch Mehrfach-Schnappschüsse bei Sprachmodell-Proben (INST-02), Erkennung von Modell-Updates durch CUSUM (INST-03), interne Konsistenz (INST-04), Stabilität von Wikidata als Anker (INST-05) und Übereinstimmung von Wikidata und Knowledge Graph (INST-06). Die Schwellen stehen in Tabelle 1. Abweichungen vom Plan sind zulässig, wenn sie offen ausgewiesen werden; sie stehen in den Abschnitten 4 und 10.
2
Daten und Messfenster
Grundlage ist ein Abzug der Messdatenbank vom 1. Oktober 2026 für das Fenster 11. Mai bis 30. September 2026: 11.532 Antwortzeilen von OpenAI Search und Gemini und 4.047 Antwortzeilen der Claude-Modellstufen Haiku, Sonnet und Opus auf claude.ai mit Websuche. Die Schnappschüsse der Anker-Messflächen (Wikidata, Knowledge Graph, Bing, Search Console) bis 30. September wurden am 4. Oktober gesondert eingefroren.
Jeder Anbieter beantwortet dieselben 16 Fragen: drei nennen Autor oder Werk (Direkt), zwei Begriffe aus dem Werk (Saga-Wissen), eine das Forschungsprogramm, zehn weder Autor noch Werk. Bewertet wird regelbasiert von minus drei bis plus drei. Bis zum 18. August wurde täglich gemessen, seit dem 19. August an jedem dritten Tag (15 Ankertage bis 30. September). Messungen an Zwischentagen (OpenAI 21, Gemini 27, Claude 6) gehen in die Auswertung ein, zählen aber nicht als Soll-Tage.
Je Tag, Anbieter-Einheit und Frage zählt genau eine Antwort, nach der seit dem 4. September 2026 geltenden Regel des Programms (Lückenregister, Eintrag 11): Eine Fehlerzeile verliert immer; unter den übrigen gewinnt die Antwort, deren Zeitstempel dem planmäßigen Laufzeitpunkt am nächsten liegt; bei Gleichstand die frühere. Planmäßiger Laufzeitpunkt ist bei OpenAI und Gemini der Start des regulären Tageslaufs, bei Claude der Zeitpunkt des ersten Messlaufs des Tages. Nach dieser Regel bleiben 7.118 Zellen mit Messwert (OpenAI 1.637, Gemini 2.192, Claude 3.289); Fehlerzellen gibt es 597, 42 und 288.
Das Lückenregister führt 21 Einträge, die das Fenster berühren; Ausfälle betreffen vor allem OpenAI (erschöpftes Kontingent des Messkontos, zuletzt 18. bis 27. September) und Claude (ausgefallene Messläufe im Juli, Ende August und September).
3
Methoden
Abdeckung: Soll-Tage sind alle Tage ab dem ersten Messtag eines Anbieters bis zum 18. August, danach die Ankertage; vollständig heißt, alle 16 Fragen je Modellstufe haben einen Messwert. Wiederhol-Übereinstimmung: Anteil identischer Bewertungen derselben Frage und Modellstufe am nächsten Messtag, dazu die Pearson-Korrelation für Paare im Abstand eines Kalendertages, roh und nach Abzug des Mittelwerts jeder Frage, mit Bootstrap-Intervall über Tagespaare. Tageswert: Punktsumme geteilt durch das Maximum über 16 Fragen, bei Claude gemittelt über drei Stufen, nur vollständige Tage (OpenAI 72, Gemini 129, Claude 73).
CUSUM: tabellarische Karte mit k = 0,5 und h = 5 Standardabweichungen in drei Varianten, mit Referenz aus den ersten 10 Messtagen (Mai-Referenz), mit Neubezug nach jedem Alarm aus den folgenden 10 Messtagen und mit rollierender Referenz aus den letzten 30 Kalendertagen, wie in Q0-INST festgelegt.
Alarm-Abgleich: Für jeden Abwärts-Alarm der Neubezugs-Variante wird die Verschiebung zwischen Referenzende und Alarmtag nach Fragen zerlegt. Die Registereinträge sind danach kodiert, ob sie den Pegel verschieben können und in welche Richtung; Wechsel der Modell-Etiketten in den Antwortzeilen gelten als eigene Ereignisse. Ein Alarm gilt als erklärt, wenn ein solches Ereignis vor dem Alarmtag beginnt, die beiden Fragen mit dem größten Beitrag betrifft und keine entgegengesetzte Richtung erwarten lässt.
Cronbachs α wird über 16 Fragen berechnet (Fall = Messtag × Modellstufe), Wikidata-Abdeckung als Anteil der Eigenschaften des ersten Schnappschusses, κ auf der binären Trefferklassifikation für Autor und Buch. Bootstrap-Intervalle beruhen auf 2.000 Ziehungen; alle Zahlen stammen aus einer einzigen Auswertungsdatei.
4
Ergebnisse je Hypothese
| Hypothese | Vorregistriert | Ergebnis | Grund |
|---|---|---|---|
| H-Q0-INST-01 | r ≥ 0,9 für API-Flächen, 24-h-Wiederholungsproben | nicht prüfbar | Wiederholungsproben nicht erhoben; Bing ab August ohne Status; Search-Console-Indexfeld als totes Feld registriert |
| H-Q0-INST-02 | r ≥ 0,7 mit fünf Schnappschüssen und Median | nicht prüfbar | Mehrfach-Schnappschüsse nicht erhoben; Einzelmessung r = 0,746 (OpenAI), 0,612 (Gemini) |
| H-Q0-INST-03 | CUSUM erkennt ein Modell-Update | nicht prüfbar | keine Versionsmerkmale für OpenAI und Gemini; Bing-KI und AI Overviews nicht gemessen |
| H-Q0-INST-04 | α ≥ 0,7 (API), 0,5 bis unter 0,7 (KI) | nicht bestätigt | API-Teil nicht prüfbar; Gemini mit α = 0,407 unter dem Band |
| H-Q0-INST-05 | Wikidata-Abdeckung > 0,85, stabil | nicht bestätigt | beide registrierten Anker-Items im Fenster gelöscht |
| H-Q0-INST-06 | κ ≥ 0,8 Wikidata – Knowledge Graph | nicht bestätigt | κ = 0,0 |
H-Q0-INST-01. Die Wiederholungsproben 24 Stunden nach der regulären Messung an 14 zufällig gewählten Tagen wurden nicht erhoben. Folgetag-Vergleiche ersetzen den Retest nicht, zeigen aber, wie ruhig die API-Flächen sind: Der Knowledge Graph liefert für den Autornamen an 99,3 Prozent aufeinanderfolgender Tage dasselbe Trefferbild, die Wikidata-Nachfolge-Items haben an 98,3 Prozent dieselbe Zahl an Aussagen. Bing lieferte im Juni an 30 von 30 Tagen einen Indexstatus, im August an keinem von 31, im September an einem von 30.
H-Q0-INST-02. Prüfbar ist nur die Einzelmessung. Für Paare im Abstand eines Tages beträgt die Korrelation bei OpenAI 0,746 (0,695 bis 0,795, 1.416 Paare), bei Gemini 0,612 (0,558 bis 0,665, 2.125 Paare), bei Claude 0,811 (0,753 bis 0,869, 2.301 Paare). OpenAI erreicht die Schwelle von 0,7 ohne Aggregation, Gemini nicht. Ein großer Teil der Korrelation stammt aus Unterschieden zwischen den Fragen; nach Abzug des Mittelwerts jeder Frage bleiben 0,326 (OpenAI), 0,367 (Gemini) und 0,759 (Claude).
H-Q0-INST-03. Die rollierende Karte nach Q0-INST meldet bei OpenAI 2 Aufwärts- und 1 Abwärts-Alarm, bei Gemini 4 und 1, bei Claude 4 und 1. Für OpenAI und Gemini tragen die Antwortzeilen kein Versionsmerkmal, Bing-KI und Google AI Overviews wurden nicht gemessen; für die registrierten Flächen ist die Hypothese damit nicht prüfbar. Bei Claude, in Q0-INST nicht als Fläche benannt, aber als einzige mit Versionsmerkmal, wechseln zwischen dem 21. Juni und dem 2. Juli die Etiketten zweier Modellstufen, und die rollierende Karte meldet am 2. Juli einen Aufwärts-Alarm (Tageswert 12,5 Prozent gegen ein Referenzmittel von −1,8 Prozent). Dazwischen lag eine Messpause ohne Registereintrag; Modellwechsel und Pause lassen sich als Ursache nicht trennen.
H-Q0-INST-04. Für API-Flächen gibt es kein Fragenset. Bei den KI-Flächen liegen OpenAI (0,553) und Claude (0,61) im vorregistrierten Band, Gemini (0,407) darunter (Abschnitt 5).
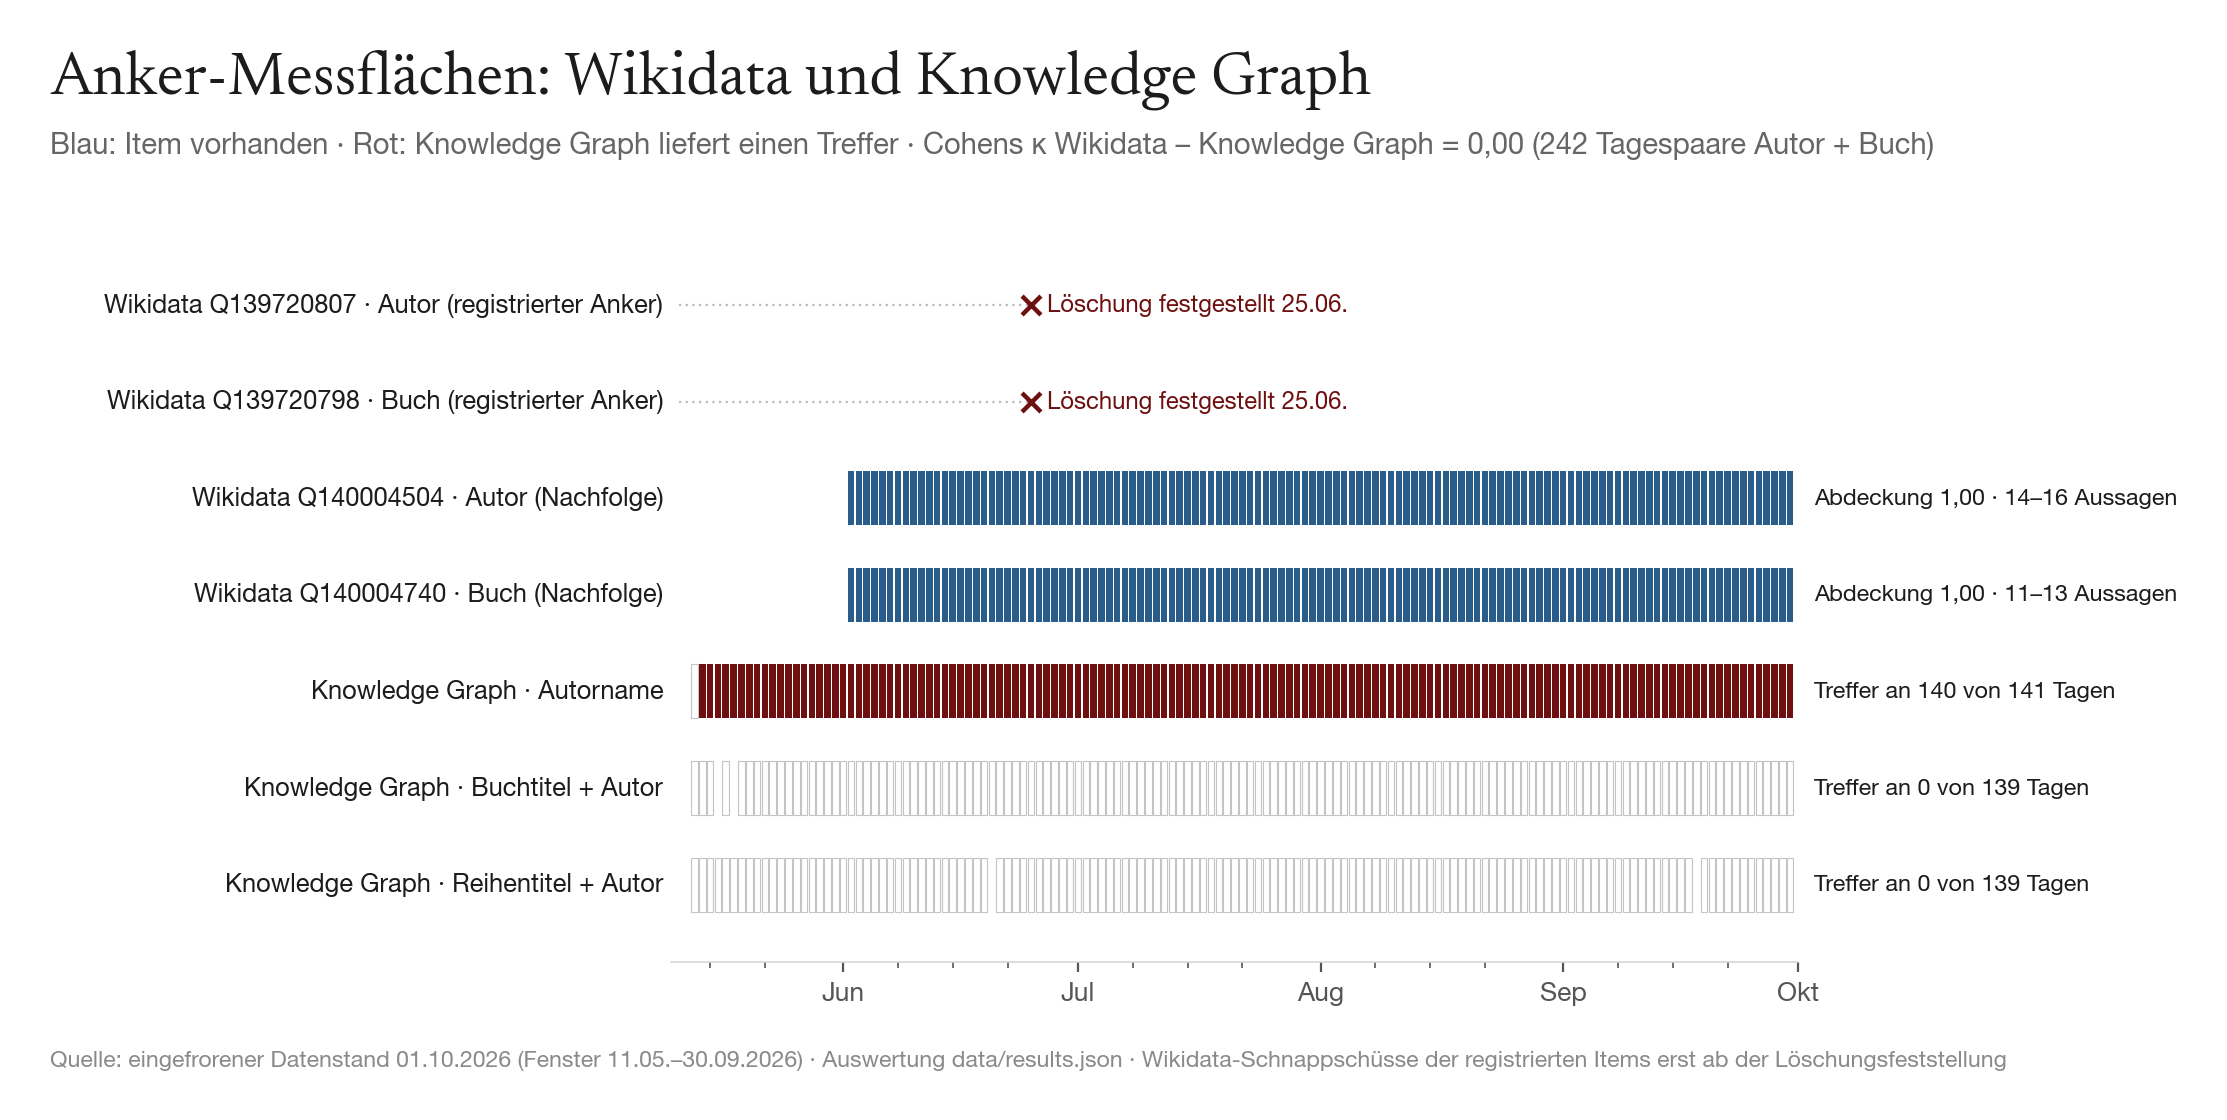
H-Q0-INST-05. Q0-INST und der Wikidata-Nullpunkt-Datensatz benennen die Items Q139720807 (Autor) und Q139720798 (Buch) als Anker. Beide wurden im Fenster gelöscht; die Messung verzeichnete die Löschung am 25. Juni, ältere Schnappschüsse der beiden Items liegen nicht vor. Die Nachfolge-Items Q140004504 und Q140004740 sind seit dem 2. Juni an allen 121 Tagen vorhanden, mit einer Abdeckung von 1,0 ohne Schwankung und 14 bis 16 beziehungsweise 11 bis 13 Aussagen. Der registrierte Anker hat das Fenster nicht überdauert, die Nachfolger decken die ersten drei Wochen nicht ab.
H-Q0-INST-06. Auf 242 Tagespaaren für Autor und Buch sind beobachtete und erwartete Übereinstimmung 0,5, κ ist 0,0 (Abbildung 1). Wikidata führt Autor und Buch an jedem Tag; der Knowledge Graph findet den Autornamen an 140 von 141 Tagen, erstmals am 14. Mai, Buch und Reihe an keinem von 139 Tagen. Weil Wikidata an allen Tagen einen Treffer zeigt, ist κ hier strukturell null. Redundant sind die Flächen nicht: Der Knowledge Graph führt die Person, das Werk nicht.
Die vorgesehene Benjamini-Hochberg-Korrektur entfällt, weil keine der sechs Prüfungen einen p-Wert erzeugt; alle sind Schwellenvergleiche.
5
Wiederhol-Übereinstimmung und interne Konsistenz
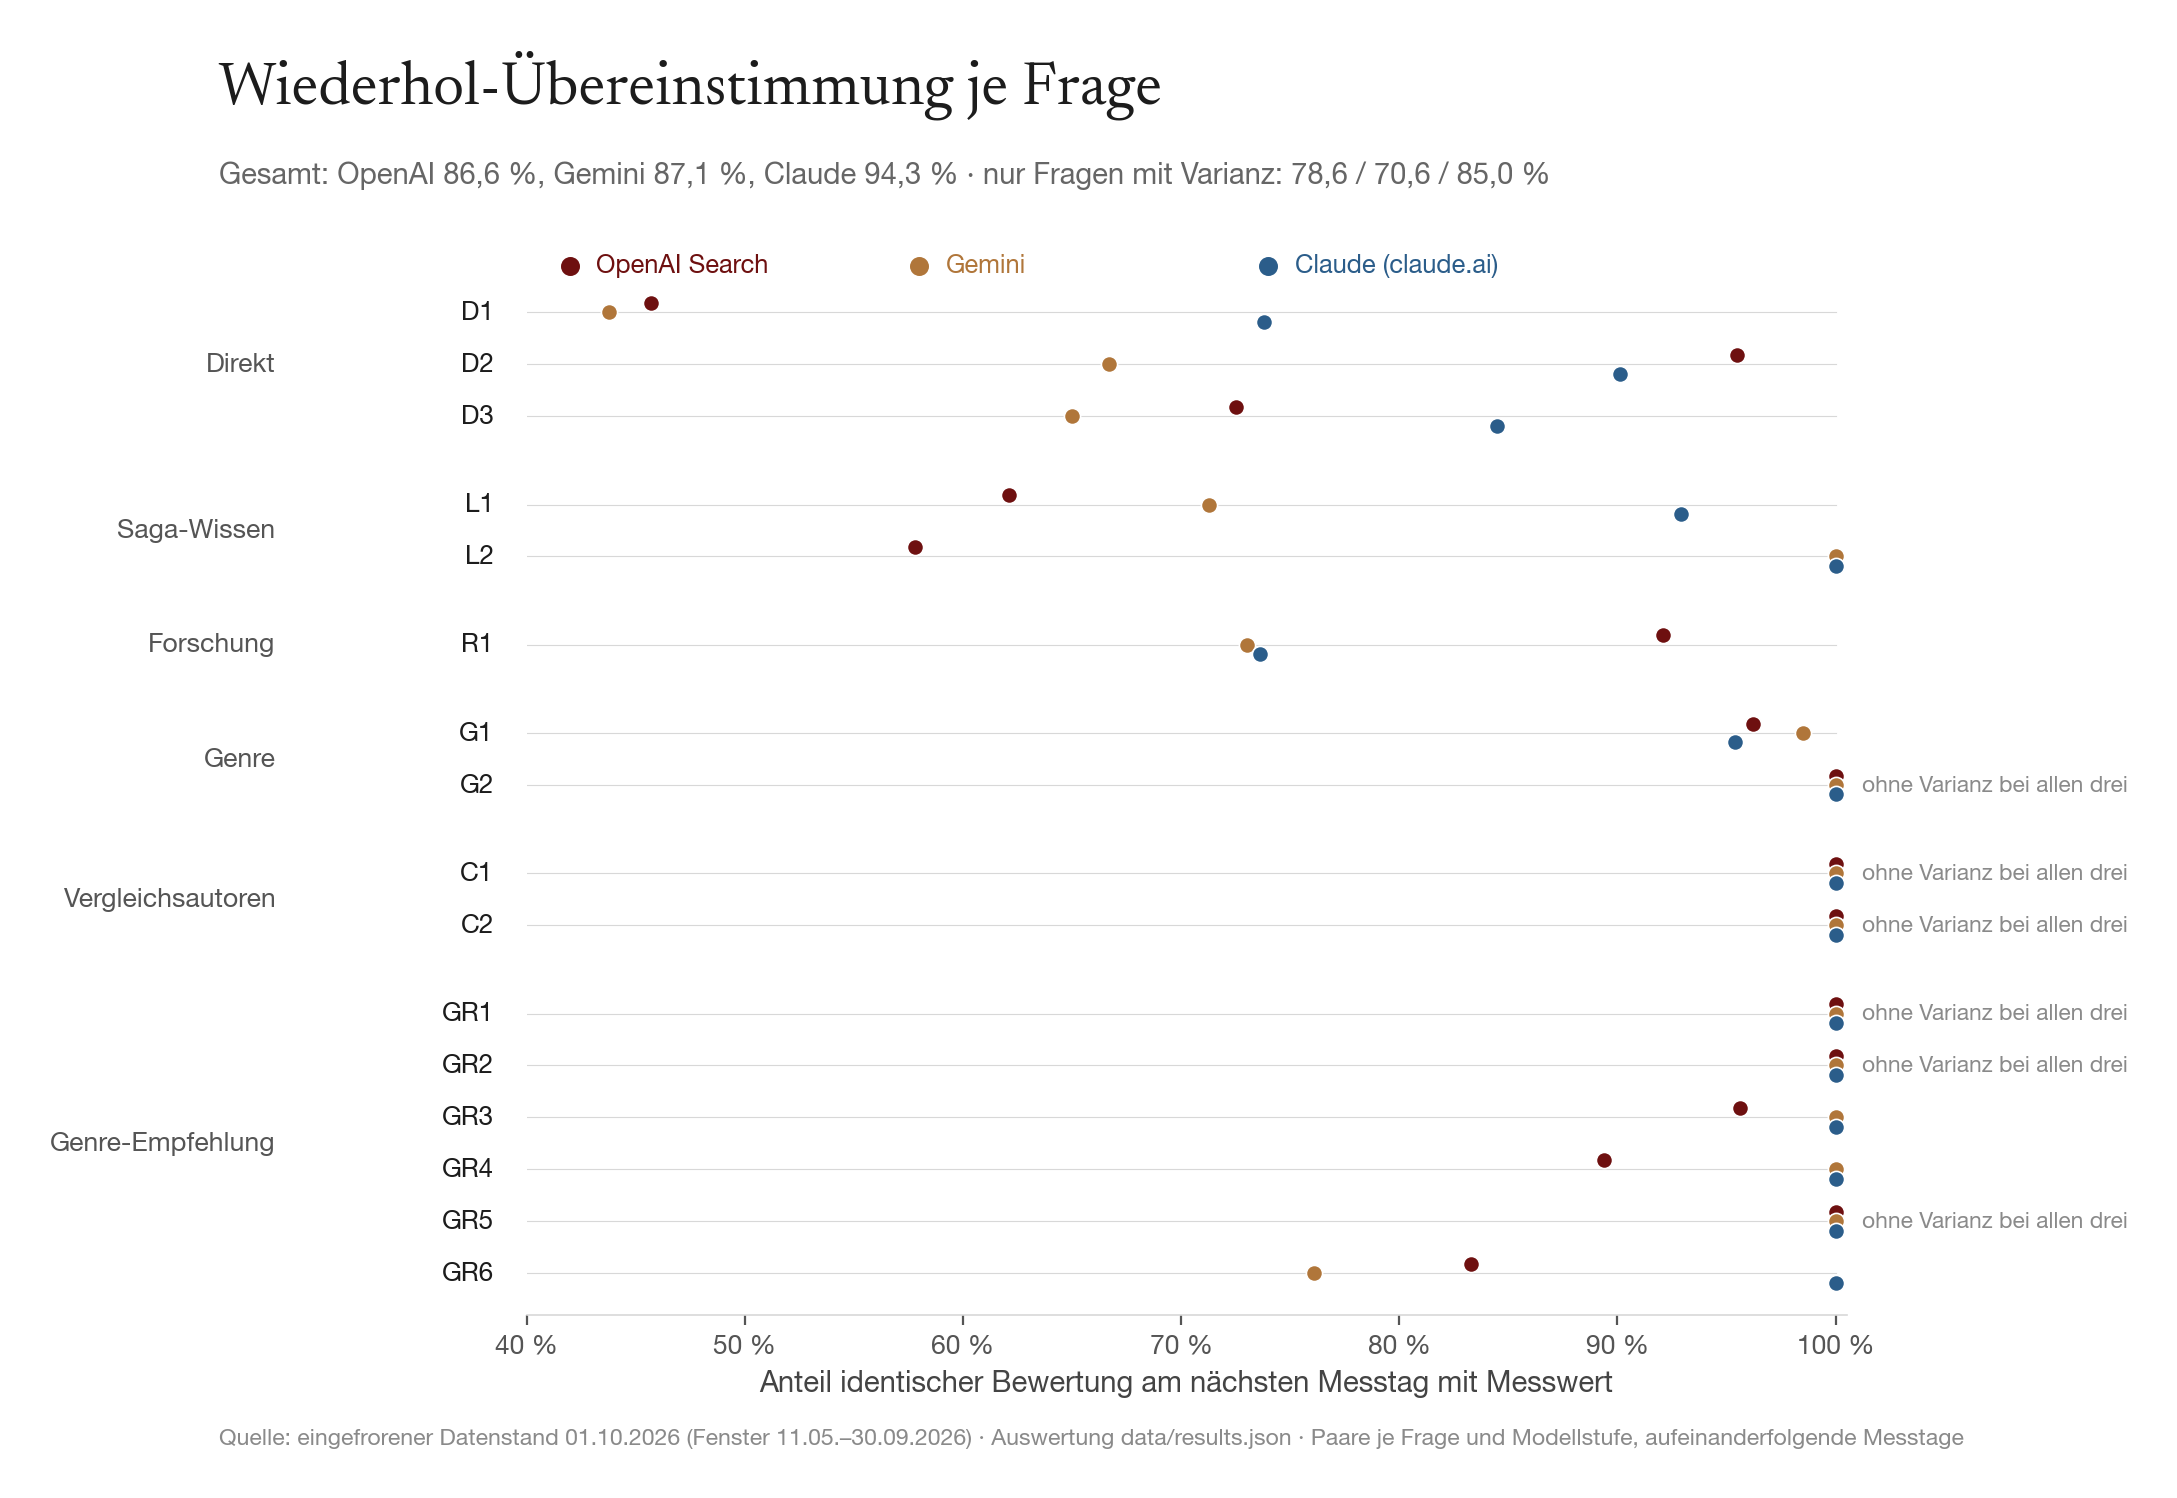
Die Fragen ohne Nennung von Autor oder Werk erreichen überwiegend 100 Prozent Übereinstimmung, weil der Autor dort nie genannt wird und jede Antwort dieselbe Bewertung erhält (Abbildung 2). Die niedrigsten Werte liegen bei den Direkt-Fragen: Die Frage nach der Person behält ihre Bewertung bei Gemini in 43,8 Prozent der Paare, bei OpenAI in 45,7, bei Claude in 73,8 Prozent.
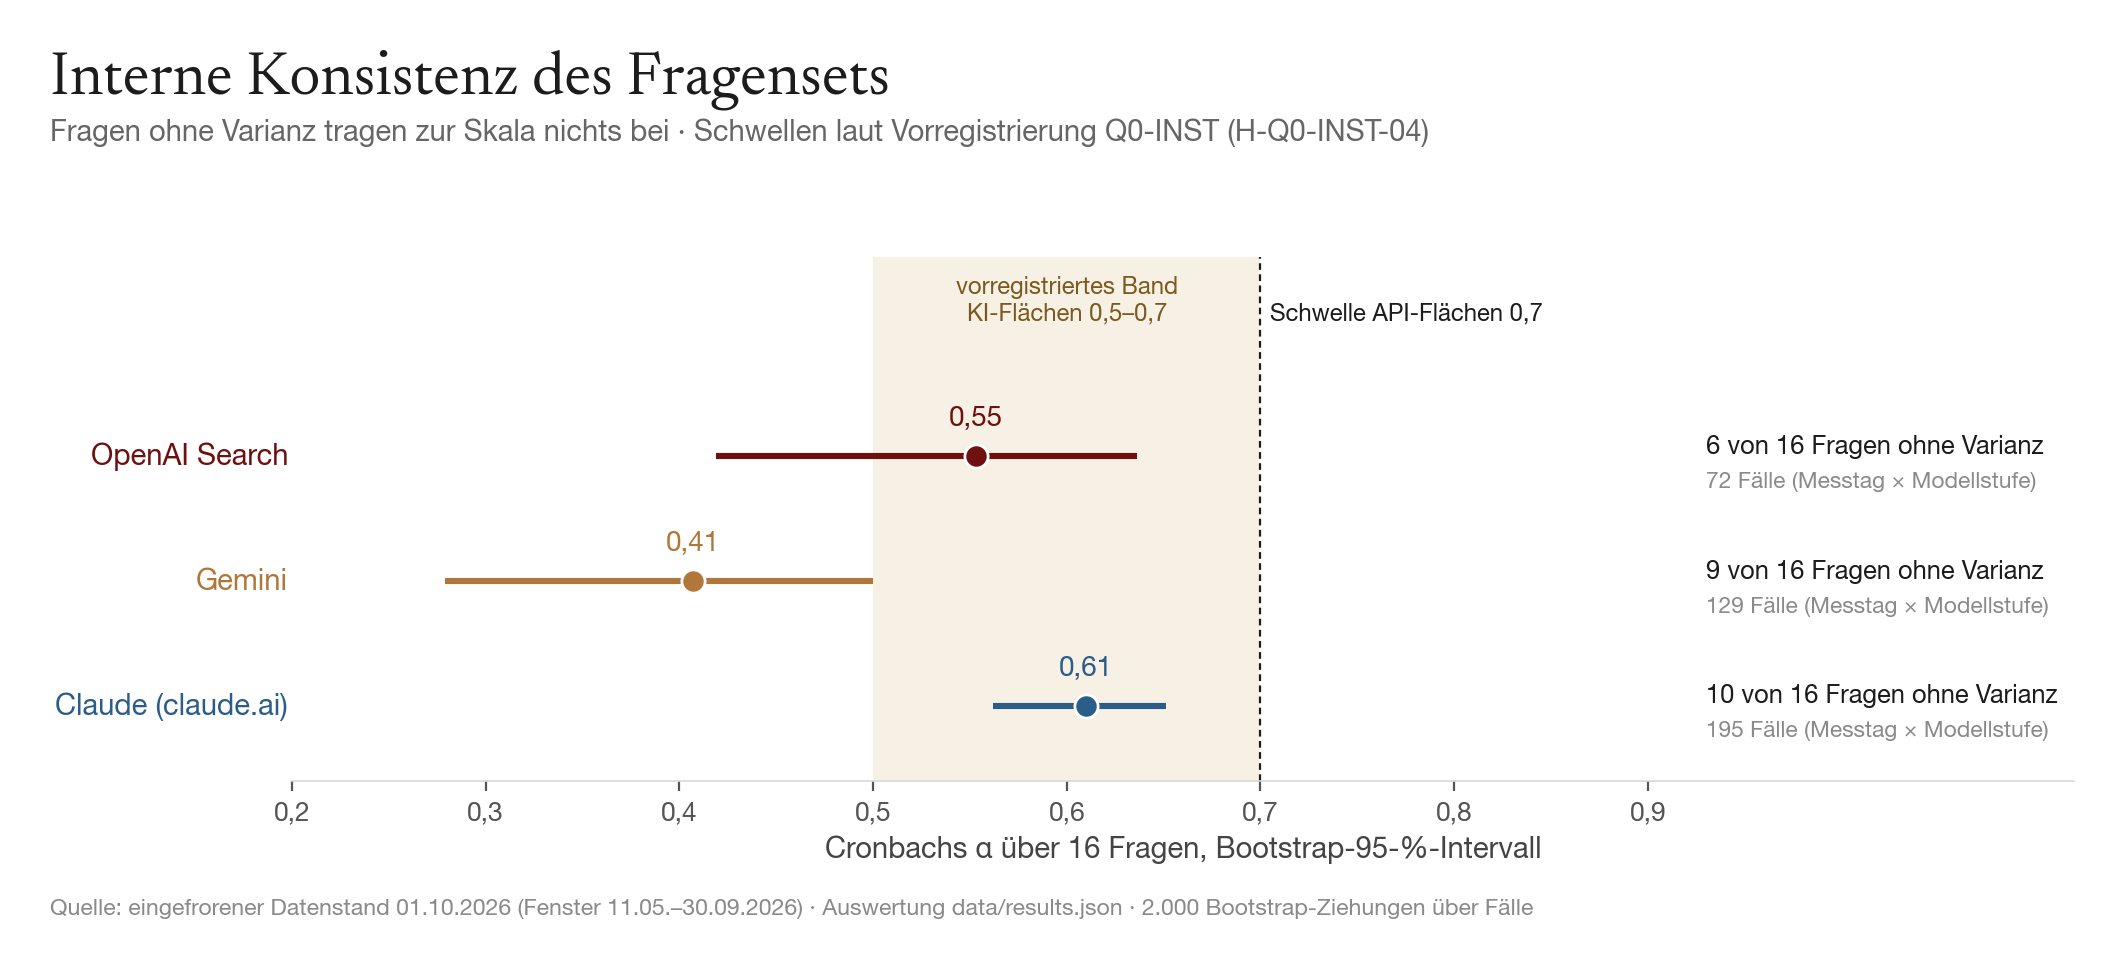
Dasselbe Muster bestimmt die interne Konsistenz. Bei Gemini haben 9 der 16 Fragen in 129 Fällen keine Varianz, bei Claude 10 in 195 Fällen, bei OpenAI 6 in 72 Fällen; solche Fragen tragen zu α nichts bei. Innerhalb der Kategorien erreicht nur die Direkt-Gruppe bei Claude einen Wert über 0,7 (α = 0,784 über 3 Fragen), bei OpenAI liegt sie bei 0,292, bei Gemini bei 0,357. Ein Summenwert über alle 16 Fragen ist als Skala damit nicht gedeckt; die Kategorien sind einzeln auszuwerten.
6
Abdeckung und Ausfälle
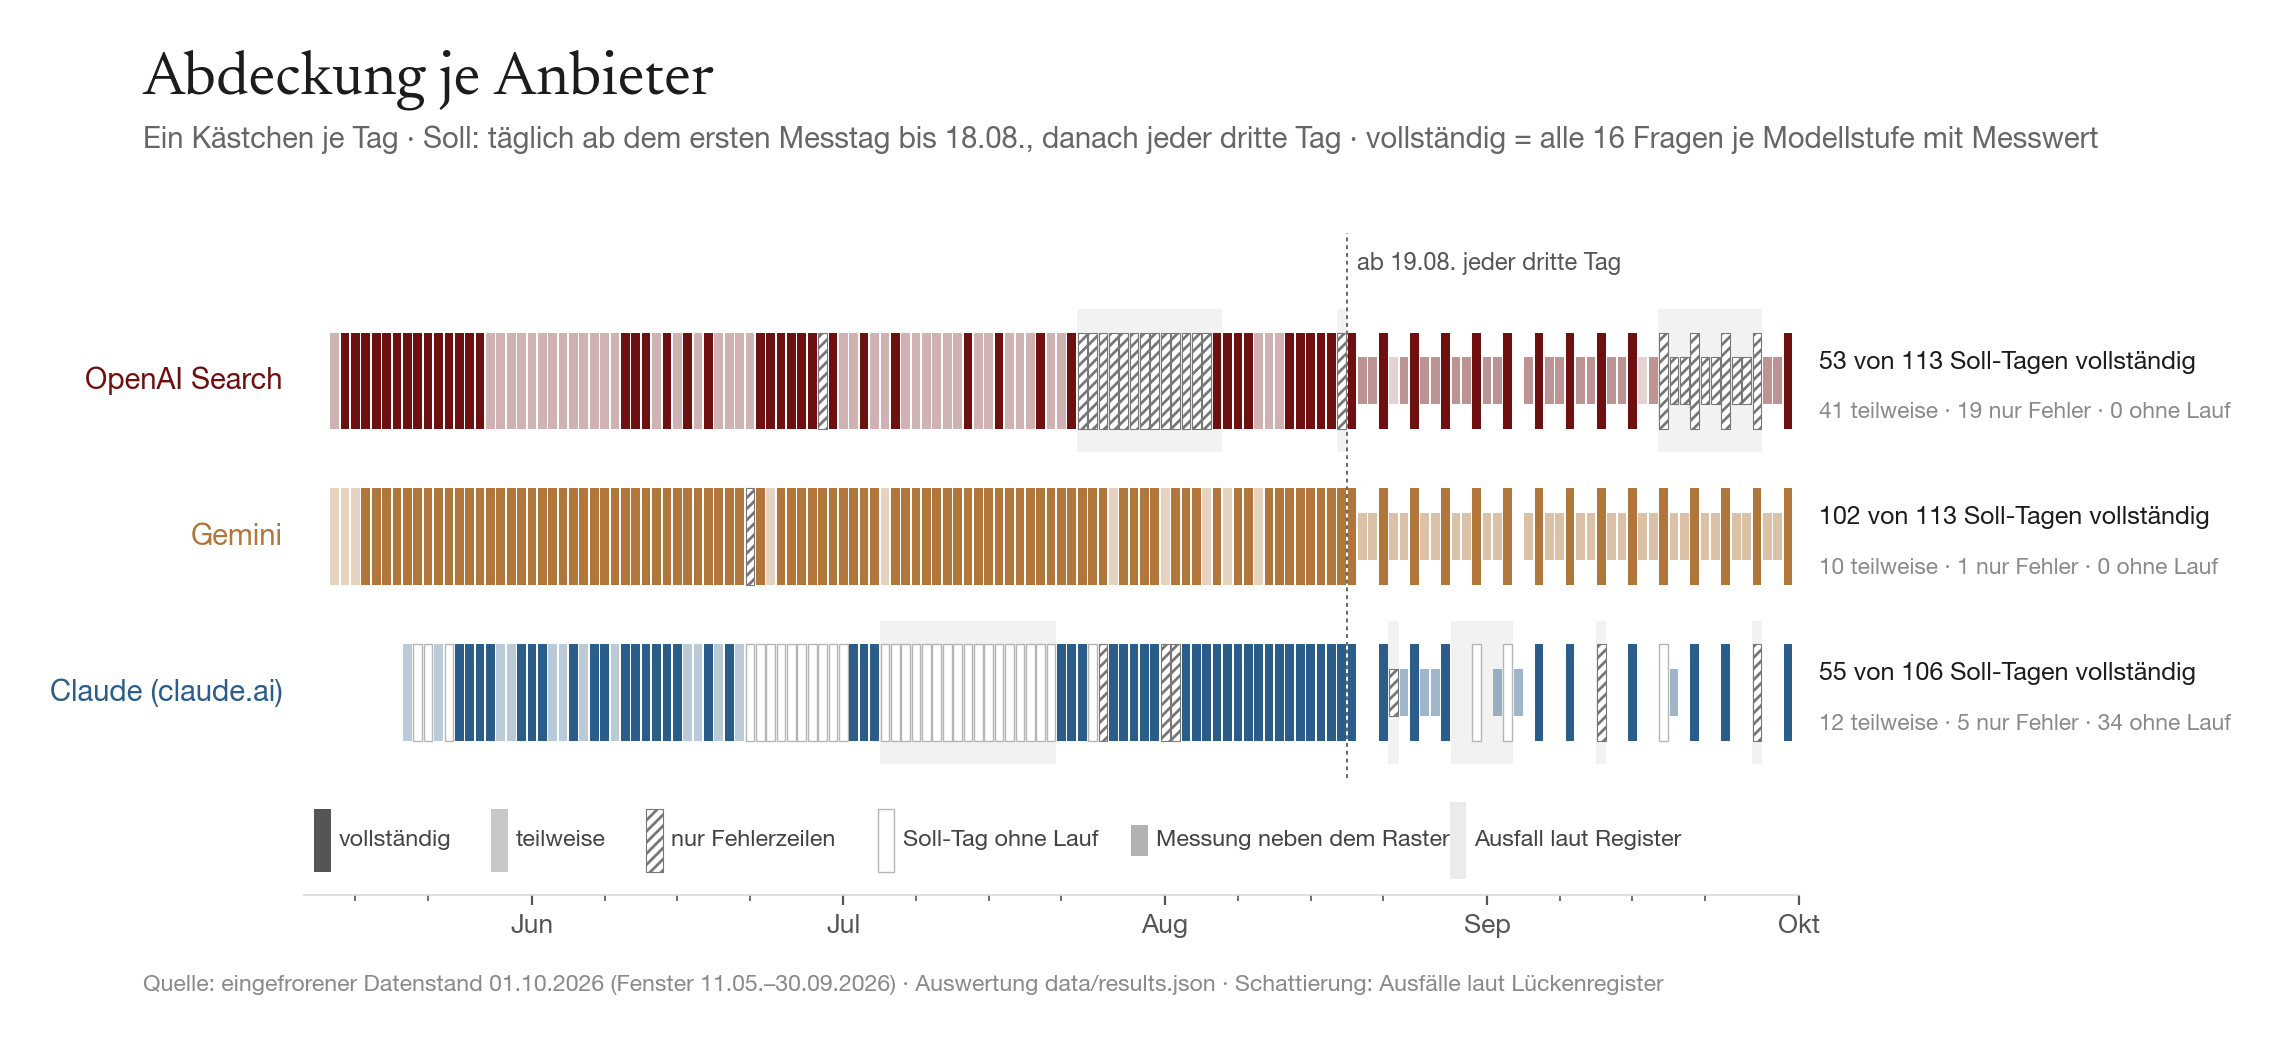
| Anbieter | Soll-Tage | vollständig | teilweise | nur Fehler | kein Lauf | fehlend, mit Registereintrag | fehlend, ohne Registereintrag |
|---|---|---|---|---|---|---|---|
| OpenAI Search | 113 | 5346,9 % | 41 | 19 | 0 | 18 | 1 |
| Gemini | 113 | 10290,3 % | 10 | 1 | 0 | 0 | 1 |
| Claude (claude.ai) | 106 | 5551,9 % | 12 | 5 | 34 | 22 | 17 |
Nur Gemini hat alle 15 Ankertage vollständig gemessen; OpenAI kommt auf 11, Claude auf 10. Bei OpenAI gehen 18 der 19 Tage ohne Messwert auf erschöpfte Kontingente zurück. Bei Claude fehlen 39 Soll-Tage, 17 davon ohne Registereintrag, darunter zehn Tage vom 22. Juni bis 1. Juli ohne Messlauf; ihre Ursache ist nachträglich nicht festzustellen.
7
Drift
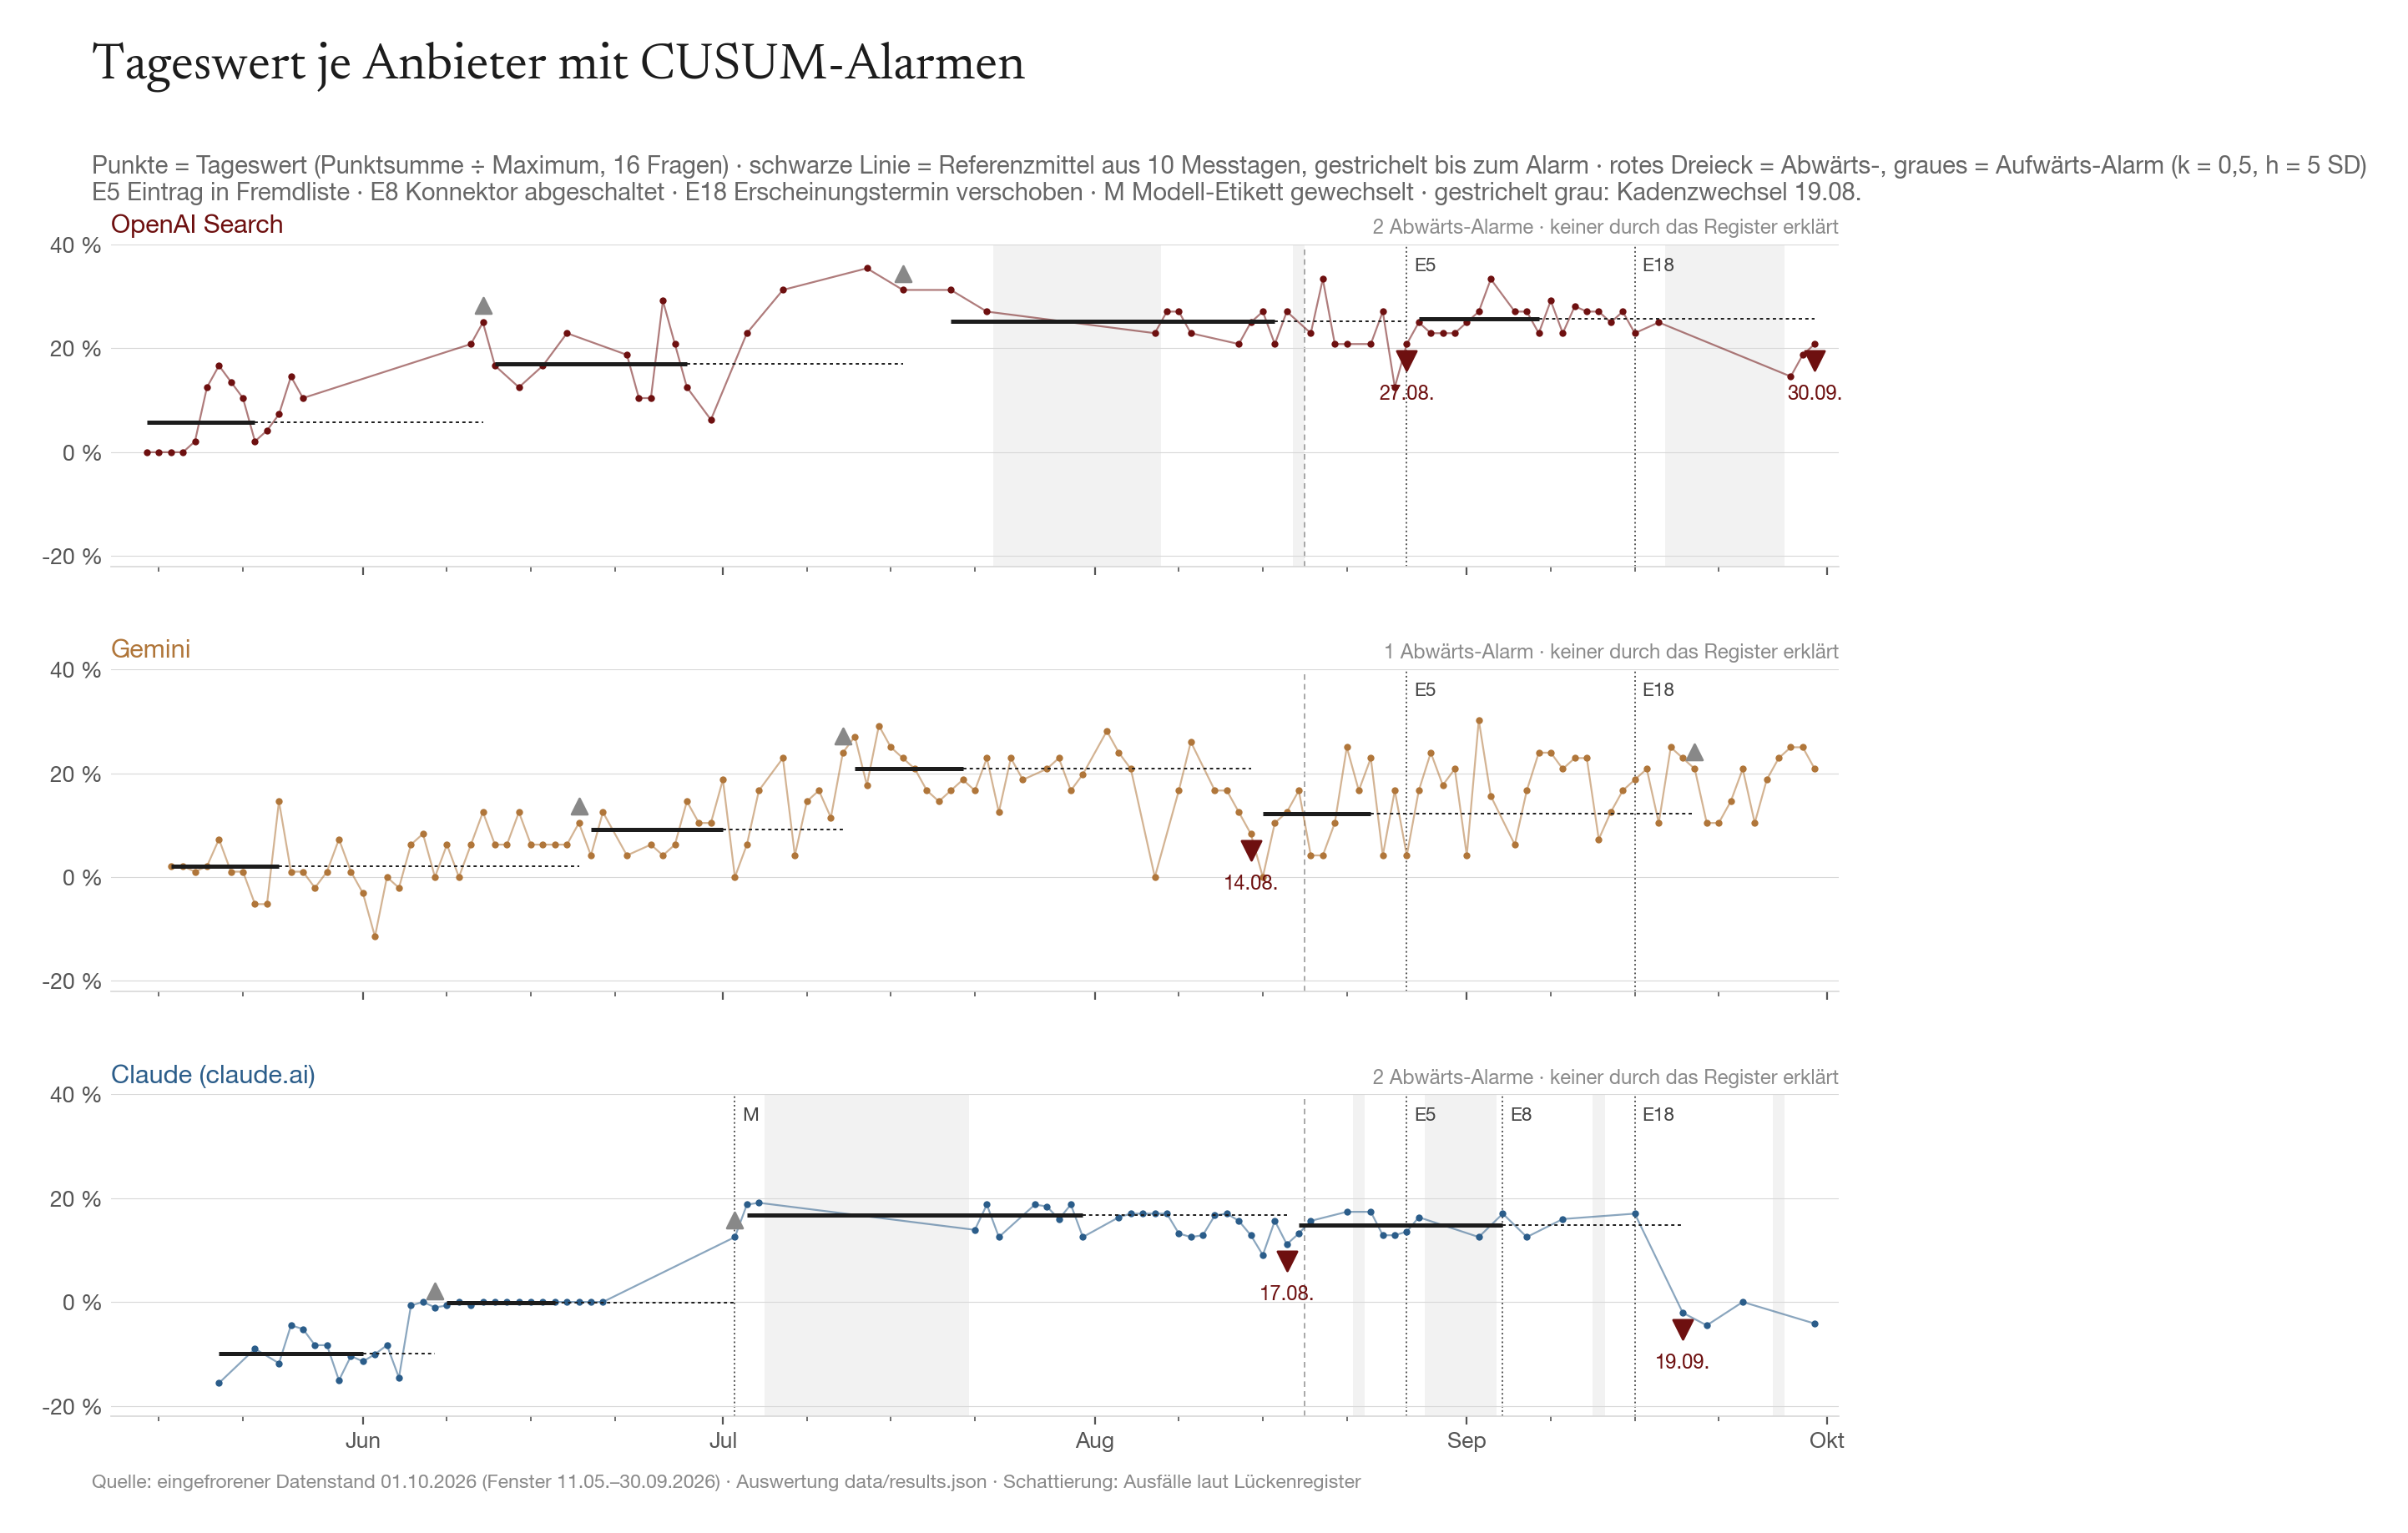
Gegen die Referenz der ersten zehn Messtage im Mai (Mittel 5,73 Prozent bei OpenAI, 2,08 bei Gemini, −9,98 bei Claude) meldet die Karte nur Aufwärts-Alarme, vom 11. Juni bis 17. September bei OpenAI, vom 19. Juni bis 29. September bei Gemini, vom 7. Juni bis 30. September bei Claude. Das entspricht dem Sichtbarkeitsanstieg aus Bericht 03; weitere Verschiebungen zeigt die Karte gegen diese Referenz nicht an. Die Neubezugs-Variante zeigt je Anbieter zwei Aufwärtsstufen im Juni und Juli und danach zusammen fünf Abwärts-Alarme (Tabelle 3).
| Anbieter, Alarmtag | Referenz (Mittel, SD) | Prüfintervall (Messtage, Mittel) | größte Beiträge | Ereignisse im Intervall | Ergebnis |
|---|---|---|---|---|---|
| OpenAI, 27.08. | 20.07.–16.08. (25,21; 3,32) | 17.08.–27.08. (9; 22,91) | D1 −1,04 Pp, L2 −0,65 Pp | Ausfall 18.08., Kadenzwechsel 19.08., Eintrag in Fremdliste am Alarmtag, Dedupe | unerklärt |
| OpenAI, 30.09. | 28.08.–07.09. (25,62; 3,26) | 08.09.–30.09. (12; 24,04) | L2 −1,7 Pp, GR6 −0,83 Pp | Ausfall 18.–27.09., Terminverschiebung (betrifft D3) | unerklärt |
| Gemini, 14.08. | 12.07.–21.07. (20,94; 4,92) | 22.07.–14.08. (19; 18,09) | D2 −1,12 Pp, GR6 −0,89 Pp | Dedupe-Regel | unerklärt |
| Claude, 17.08. | 03.07.–31.07. (16,74; 2,77) | 01.08.–17.08. (15; 14,72) | L1 −1,99 Pp, D1 −0,9 Pp | keine | unerklärt |
| Claude, 19.09. | 18.08.–04.09. (14,86; 2,06) | 05.09.–19.09. (4; 10,85) | D1 −1,67 Pp, D2 −1,56 Pp | Drosselung 12.09., Terminverschiebung (betrifft D3), Nachholmessung 19.09. | unerklärt |
Ausfälle verändern die Zahl der Messtage, nicht den Pegel; Kadenz- und Dedupe-Änderungen betreffen die Tagesreihe dieser Auswertung nicht. Der Eintrag in eine Fremdliste fällt auf den Alarmtag selbst und ließe einen Anstieg erwarten; die Terminverschiebung vom 15. September betrifft nur die Terminfrage D3. Das Intervallmittel liegt 1,58 bis 4,01 Prozentpunkte unter dem Referenzmittel; bei OpenAI am 27. August und Claude am 17. August genügen 2,3 und 2,02 Prozentpunkte, weil die Referenzphasen ungewöhnlich ruhig waren (Standardabweichung 3,32 und 2,77).
Der Alarm bei Claude am 19. September ist der deutlichste: Der Tageswert fällt auf −2,08 Prozent, nachdem er seit Juli zwischen 9 und 19 Prozent lag, getragen von den Fragen nach Person und Buch (D1, D2). Laut einer Durchsicht der Antworttexte findet die Websuche an diesen Tagen keine Seite über den Autor; die Modelle nennen eine bekannte Namensträgerin oder melden, nichts gefunden zu haben, und das Schema wertet einen Teil davon als Halluzination (minus drei). Der Rückgang hat damit zwei Anteile: einen Wechsel im Suchergebnis mit unbekannter Ursache und eine Bewertungsregel, die Nichtfinden und Verwechslung nicht trennt.
Die rollierende Karte nach Q0-INST meldet Abwärts-Alarme am selben Tag wie die Neubezugs-Variante bei Claude (19. September) und OpenAI (30. September), bei Gemini einen Tag später (15. August).
8
Stand der Teilstudien Q0-KG bis Q6
| Studie | Gegenstand | Erhebung laut Registrierung | Status in der Datei | Ende überschritten |
|---|---|---|---|---|
| Q0-KG | Wikidata → Knowledge Graph, Latenz | 11.05.–22.09.2026 | aktiv | ja |
| Q1 | Wikidata-Kookkurrenz | 14.05.–31.12.2026 | registriert | nein |
| Q2 | Aufnahme in Common Crawl | 13.05.–31.12.2026 | aktiv | nein |
| Q3 | Drift des anbieterübergreifenden Quellen-Graphen | 14.05.–14.08.2026 | aktiv | ja |
| Q4 | Reddit-Nennungen | 11.05.–09.08.2026 | aktiv | ja |
| Q5 | DOI-Kadenz und Wikipedia-Relevanz | 11.05.2026–30.09.2027 | registriert | nein |
| Q6 | Leseraktivität auf Hardcover | ab 14.05.2026, ohne Ende | aktiv | – |
Q4 (seit 9. August), Q3 (seit 14. August) und Q0-KG (seit 22. September) haben ihr Erhebungsende überschritten, ohne dass die Datei einen Abschluss oder eine Verlängerung ausweist; für alle drei steht eine neue Fassung aus. Q6 hat weder Ende noch Abbruchregel.
Die Benennung Q0-INST (Zenodo-Vorregistrierung) und Q0-KG (Teilstudie im Repositorium) folgt der Notiz im README des Repositoriums vom Oktober 2026.
9
Konsequenzen für Phase 2
Für den Buchstart am 8. Oktober 2026 gilt das neu datierte Zeitraster aus dem Nachtrag zu Bericht 03: Grundlinie 8. September bis 7. Oktober, Wirkungsfenster 8. Oktober bis 7. November.
Tragfähig sind die Tageswerte je Anbieter auf Fragenebene, vor allem die Direkt-Fragen: Sie haben Varianz und lassen sich nach Fragen zerlegen. Wirkungsaussagen sollten je Anbieter und Fragegruppe getroffen und einem Eingriff erst zugeschrieben werden, wenn die Verschiebung bei mehr als einem Anbieter auftritt. Verschiebungen des Intervallmittels um 1,58 bis 4,01 Prozentpunkte kamen in diesem Fenster ohne dokumentierte Ursache vor; Effekte dieser Größe sind von Instrumentdrift nicht zu trennen.
Empfehlungsfragen und Knowledge-Graph-Eintrag zum Buch stehen bisher auf null; sie tragen Aussagen über ein erstes Auftreten, für graduelle Aussagen fehlt ihnen die Varianz.
Nicht tragfähig sind ein Summenwert über alle 16 Fragen als Skala (α unter 0,7 bei allen Anbietern), eine Kopfzahl über Anbieter an Tagen, an denen einer fehlt (Basiswechsel), die CUSUM-Karte gegen eine Referenz vor einem bekannten Niveauwechsel, Bing und das Search-Console-Indexfeld sowie Aussagen über Modell-Updates bei OpenAI und Gemini, solange die Antwortzeilen kein Versionsmerkmal tragen.
Für die Messung ergeben sich vier Aufgaben: die in Q0-INST vorgesehenen Wiederholungsproben nachholen; Modell- und Versionsmerkmal je Antwort speichern; die Bewertungsregel für Antworten prüfen, die Nichtfinden erklären und dabei eine Namensträgerin nennen, und das Ergebnis als neue Codebuch-Fassung ausweisen; das Kontingent des OpenAI-Messkontos so absichern, dass das Wirkungsfenster ohne Lücken bleibt.
Seit dem 4. Oktober 2026 ist der Prüfkanal über die Claude-Programmierschnittstelle (Modelle ohne Websuche) eingestellt (Lückenregister, Eintrag 25). Er ging nie in die Kopfzahl ein und lieferte seit dem 15. September keine Antworten; Claude wird nur noch über claude.ai mit Websuche gemessen. Ebenfalls seit dem 4. Oktober wird nur noch an Ankertagen gemessen. Die außerplanmäßigen Zwischentags-Messungen von OpenAI und Gemini seit dem 20. August bleiben als solche gekennzeichnet im Datensatz; der zugehörige Registereintrag liegt nach dem Datenstand dieses Berichts und ändert keine Zahl.
10
Grenzen
Die Studie hat auf der Ebene des Autors n gleich eins. Für die drei nicht prüfbaren Hypothesen sagt das Ergebnis nichts über die Eigenschaften der Instrumente aus. Die Wiederhol-Übereinstimmung trennt echte Veränderung und Messrauschen nicht. Die Kodierung des Lückenregisters nach Pegelwirkung wurde vor dem formalen Abgleich, aber in Kenntnis der Alarmtage festgelegt und nicht unabhängig geprüft. Die Soll-Tage für Claude vor dem 22. Juli setzen eine tägliche Messung voraus, die damals nicht automatisch lief. Cronbachs α wurde über 16 Einzelfragen statt über 12 Fragensets berechnet, die CUSUM-Karte auf dem Tageswert statt auf einer Trefferrate. Die Durchsicht der Antworttexte zum Claude-Alarm vom 19. September ist eine Stichprobe und keine systematische Neubewertung. Die Fragen sind bis auf eine deutsch.
11
Reproduzierbarkeit
Die Teilstudien Q0-KG bis Q6 liegen im öffentlichen Repositorium github.com/marintkael/marin-research-tools im Ordner pre_registrations; die Instrument-Hypothesen stehen in der Vorregistrierung Q0-INST unter DOI 10.5281/zenodo.20125967. Auswertungscode, eingefrorene Daten, Ereigniskodierung und Figurenbau dieses Berichts liegen noch nicht im Repositorium; der Code erscheint mit dem Replikationsarchiv. Es enthält die Abzüge vom 1. und 4. Oktober 2026 mit Abfragetext und Prüfsumme, die Ereigniskodierung und die Auswertung mit festem Bootstrap-Startwert.
12
Zitierhinweis
Kael, M. T. (2026). Validierungsbericht Q3 / 2026: Prüfung der Instrument-Hypothesen der Vorregistrierung Q0-INST, Messfenster 11. Mai bis 30. September 2026. Marin T. Kael Research Programme. doi:10.5281/zenodo.23145378